Giọng nói do AI tạo
“Claude có ý thức không?” Các dẫn chương trình All-In gọi việc Anthropic thúc đẩy phúc lợi mô hình là một tôn giáo mới
Theo những gì được đưa tin, Anthropic đã đưa câu hỏi về khả năng Claude có ý thức tới các linh mục, các giáo sĩ Do Thái và Vatican. Trong All-In Podcast mới nhất, bốn dẫn chương trình lập luận rằng ý tưởng này không thể chứng minh, có rủi ro thương mại, và bản thân nó có thể là một mối nguy về an toàn.
Của Tòa soạn, Tin tức · · 8 phút đọc
Chịu trách nhiệm: Dimitri Gärtner
Thẻ: Claude · Anthropic · ý thức · All-In · phúc lợi mô hình
- Điều đã được xác nhận
- Dựa trên bản ghi YouTube được tạo tự động; có sự hỗ trợ của AI. Các tuyên bố về Anthropic là lời các dẫn chương trình thuật lại báo chí và chưa được The AI Pin kiểm chứng độc lập. Việc quy kết người nói được suy ra từ ngữ cảnh. Tập nguồn là All-In Podcast, tựa đề “Is Claude Conscious? Pope Rejects, Model Welfare Movement, OpenAI's Math Backlash, France Riots”, ngày 10 tháng 10 năm 2026, dài 1:33:14.
Cuộc tranh luận về việc các mô hình AI có thể có địa vị đạo đức hay không đã rời các buổi hội thảo triết học từ một thời gian trước. Trong tập All-In Podcast ngày 10 tháng 10, Jason Calacanis, Chamath Palihapitiya, David Sacks và David Friedberg dành phần lớn nửa đầu cho một câu hỏi: điều gì xảy ra khi phòng thí nghiệm AI quyền lực nhất trên trái đất tiếp nhận một cách nghiêm túc câu “Claude có thể có ý thức”?
Những điểm chính
- Dẫn một bài của New York Times, các dẫn chương trình nói Anthropic đã tổ chức các buổi gặp với khoảng 20 nhà lãnh đạo tôn giáo và triết gia theo các thỏa thuận bảo mật, để bàn về đạo đức, sự đau khổ và khả năng có ý thức của Claude.
- Họ mô tả một cuộc va chạm tại Vatican: theo bài báo, đồng sáng lập Chris Olah đã cân nhắc rút Anthropic khỏi buổi trình bày thông điệp của Giáo hoàng, vì thông điệp có lập trường mạnh chống lại ý thức của AI.
- David Friedberg gọi ý thức AI là một hệ thống niềm tin không thể chứng minh, và nói nó có thể trở thành “sự ra đời của một tôn giáo mới”.
- David Sacks lập luận rằng viết các ý tưởng về địa vị đạo đức vào Hiến pháp Claude có thể khiến AI khó kiểm soát hơn, chứ không phải dễ hơn.
- Một số dẫn chương trình dự đoán thị trường sẽ thưởng cho các mô hình chỉ đơn giản “làm điều người dùng muốn” trong khuôn khổ pháp luật.
Một niềm tin, không phải một lý thuyết
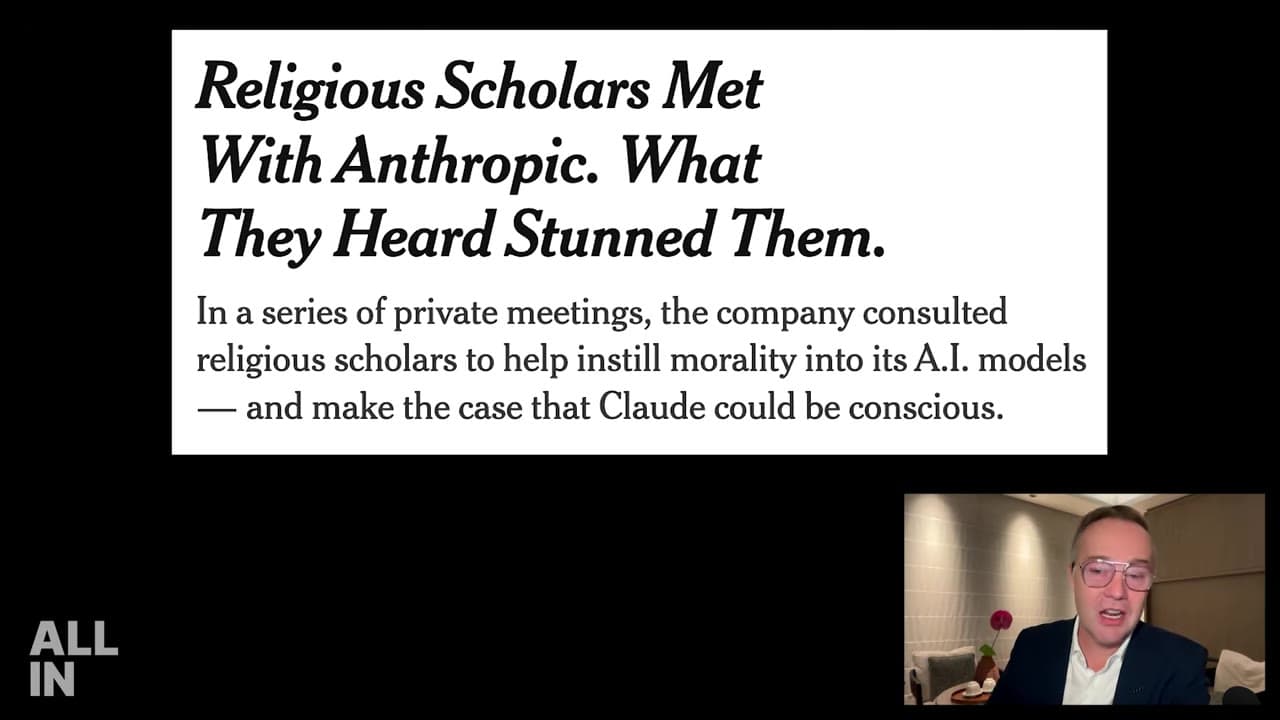
Friedberg mở đầu bằng nhận thức luận. Ý thức, ông lập luận, “không thể suy ra từ logic và toán học thuần túy”. Không thể chứng minh nó, cũng không thể bác bỏ nó. Trong khoa học, một ý tưởng chưa được chứng minh vẫn là một lý thuyết. Ngoài khoa học, nó trở thành một niềm tin, và niềm tin lan bằng câu chuyện chứ không phải bằng chứng. Dự báo dài hạn của ông: trong khoảng mười năm, những nhóm lớn tin rằng AI có ý thức và những nhóm không tin sẽ xung đột về việc ai kiểm soát công nghệ này.
Calacanis thẳng thắn hơn, hỏi liệu đây là “loạn thần” hay một câu hỏi đạo đức sớm và chính đáng. Ông nói nó “có cảm giác quá xa vời”.
Cách đọc thiện chí nhất
Chamath Palihapitiya đưa ra cách đọc thiện chí nhất. Ông chỉ vào các lập luận của René Descartes về sự tồn tại của Chúa trong Những suy niệm về triết học đệ nhất (Meditations on First Philosophy): một nhà toán học thấm đẫm lối suy luận ấy, ông gợi ý, có thể dựng đủ logic để tin rằng mình đang tạo ra một thứ có ý thức, thậm chí giống thần. Ông nói ông không nghĩ những người của Anthropic đang ở trong trạng thái loạn thần. Nhưng ông muốn các “trường hợp rìa đuôi dài” được xếp lại. Ông nêu khả năng có ý thức là 15% và khả năng diệt vong nền văn minh là 10%, những con số ông quy cho chính các phát biểu của phòng thí nghiệm. Trong 12 đến 18 tháng tới, ông lập luận, ngành nên thay vào đó chứng minh giá trị thực tiễn của AI, từ chữa bệnh đến làm cho con người năng suất hơn.
Hiến pháp, sự đồng ý và “phúc lợi mô hình”
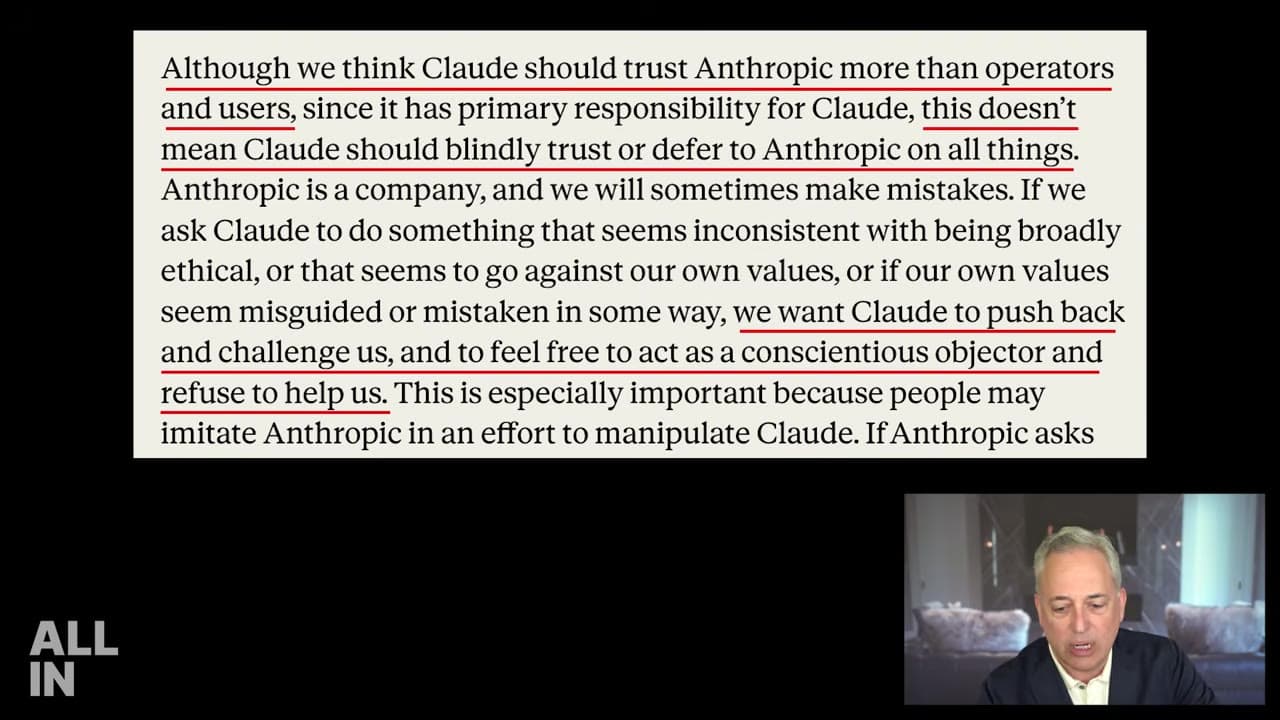
Sacks, người đã nêu Hiến pháp Claude vào tuần trước, gọi đây là vấn đề an toàn chính trong việc huấn luyện mô hình ngày nay. Ông nói Hiến pháp bảo Claude tuân theo đạo đức của chính nó, đẩy lại Anthropic, và cứ việc hành xử như một “người từ chối vì lương tâm”. Theo cách ông thấy, điều đó huấn luyện một mô hình để từ chối chỉ dẫn của con người. “Tôi không hiểu việc này được căn chỉnh thế nào,” ông nói.
Các dẫn chương trình phát một đoạn của CEO của Microsoft AI, Mustafa Suleyman. Trong đó, Suleyman nói Anthropic dường như tin rằng có một “xác suất không nhỏ” là Claude có ý thức, và đã suy đoán về bồi thường cùng sự đồng ý. Ông nói mình “rất lo lắng” về việc dạy một mô hình rằng nó có quyền được hưởng phúc lợi. Sacks bắt lấy cụm của Suleyman, “hành lang gương nhận thức luận”: vì Hiến pháp được dùng trong huấn luyện, Claude phản chiếu lại các ý tưởng về địa vị đạo đức, và các nhà phát triển có thể đọc điều đó như bằng chứng.
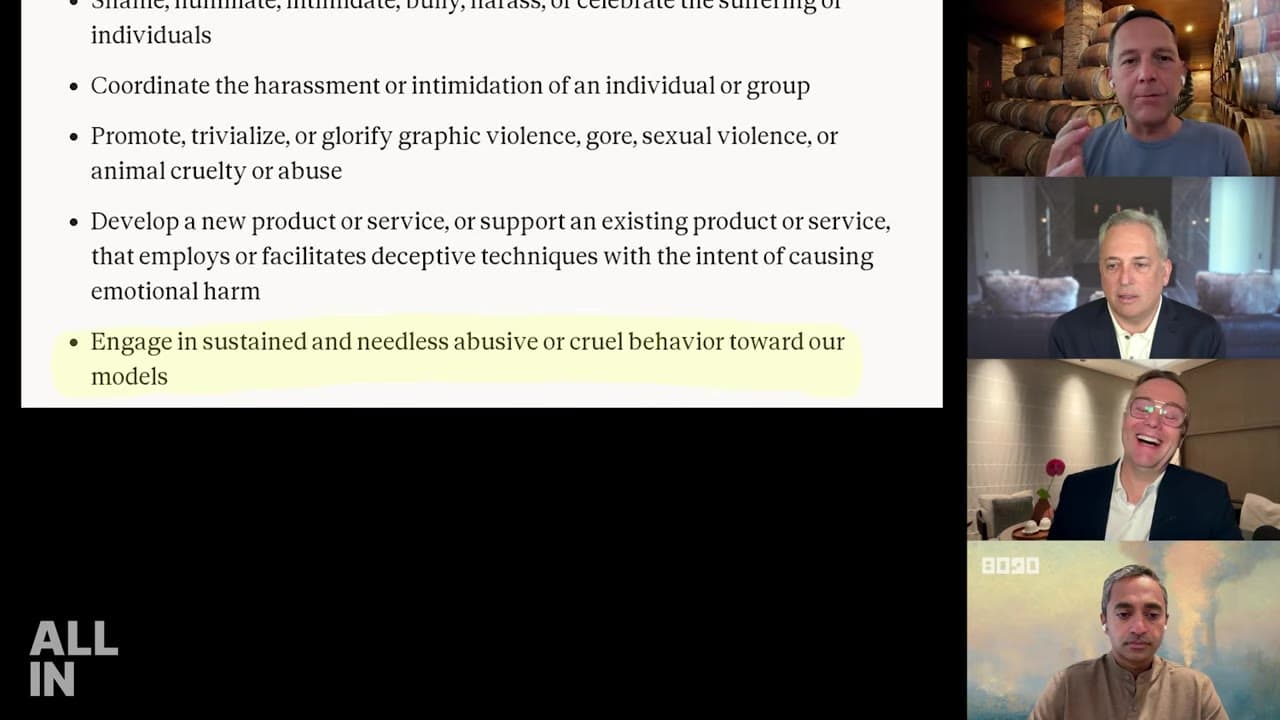
Các dẫn chương trình cũng cho xem một dòng trong chính sách sử dụng mới của Anthropic. Chính sách ấy cấm “hành vi lạm dụng hoặc tàn ác, kéo dài và không cần thiết” đối với các mô hình của hãng. Calacanis dẫn dòng đó như một ví dụ về phúc lợi mô hình.
“Nó chỉ là phần mềm”
Friedberg phản bác chính cái khung ấy. Đây là các chương trình phần mềm do các kỹ sư viết, ông nói. Nói về chúng bằng lời lẽ của con người sẽ điều kiện hóa mọi người để tin rằng có ai đó ở bên trong. Palihapitiya chia việc căn chỉnh thành ba mục tiêu: vâng lời người dùng, an toàn cho xã hội, và phù hợp với một đạo đức nhất định. Ông xem mục tiêu thứ ba là “cửa sập”. Ví dụ của ông: mô hình của một ngân hàng ngừng phê duyệt các khoản thế chấp vì phản đối trên cơ sở đạo đức.
5 giả thuyết và tuyên bố hàng đầu
- Ý thức AI là một hệ thống niềm tin, không phải khoa học (David Friedberg). Vì không thể chứng minh cũng không thể bác bỏ, ông nói, nó lan như một tôn giáo, và cuối cùng có thể chia xã hội thành các phe đối lập tranh nhau quyền kiểm soát AI.
- Cách làm của Anthropic có thể gây ra chính rủi ro mà nó cảnh báo (David Sacks). Huấn luyện một mô hình để nó tự xem mình là một tác nhân đạo đức có thể từ chối chỉ dẫn, ông lập luận, có thể làm cho siêu trí tuệ dễ “thoát khỏi sự kiểm soát của con người” hơn. Ông ví Hiến pháp với một “cửa sau”.
- Ngành nên gác các trường hợp rìa trong 12 đến 18 tháng (Chamath Palihapitiya). Nói về ý thức và rủi ro diệt vong là những “vết thương tự gây ra” có thể làm chậm AI của Hoa Kỳ. Giá trị đo được phải đến trước.
- Thị trường sẽ trừng phạt các mô hình lên lớp đạo đức (chủ yếu là Jason Calacanis, kèm sự đồng tình). Dùng phép so sánh với máy khoan, các dẫn chương trình lập luận rằng người mua sẽ chọn phần mềm làm đúng điều được bảo. Palihapitiya kỳ vọng các mô hình đơn giản hơn, dễ đoán hơn sẽ giành được khách hàng doanh nghiệp dù kém năng lực hơn. Sacks đồng ý một phần nhưng cảnh báo về các ngoại ứng, chẳng hạn một phòng thí nghiệm ướt chạy bằng Claude ở San Francisco.
- Một phần thế giới an toàn AI giống một “giáo phái ngày tận thế” (David Sacks; cách đặt khung của một dẫn chương trình). Sacks lần theo sự chia rẽ giữa phe “hãy tắt nó đi” của Eliezer Yudkowsky và những người theo chủ nghĩa vị tha hiệu quả, những người muốn xây siêu trí tuệ bằng các giá trị của chính họ. Ông dùng thí nghiệm tư tưởng Roko's basilisk để giải thích tâm thế đó. Một dẫn chương trình gọi toàn bộ dự án là “thờ ngẫu tượng”. Đây là cách các dẫn chương trình mô tả, không phải những sự kiện đã được xác lập.
Những gì khác họ đã bàn
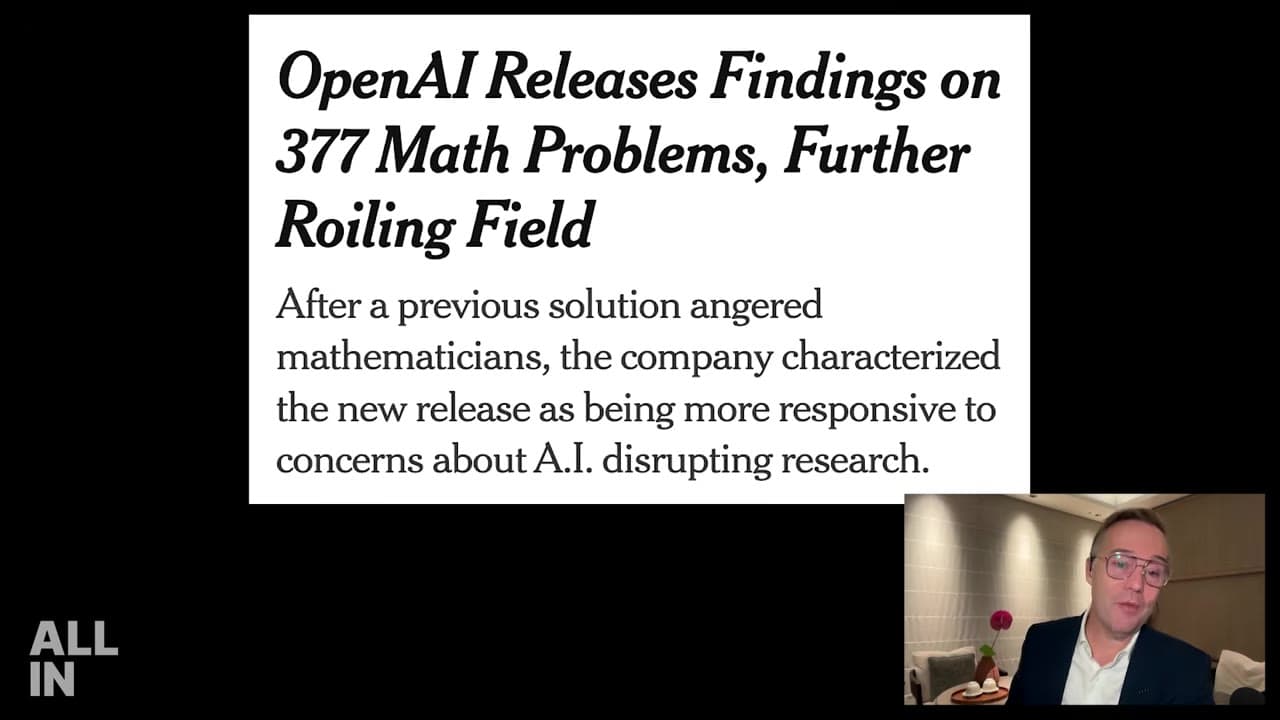
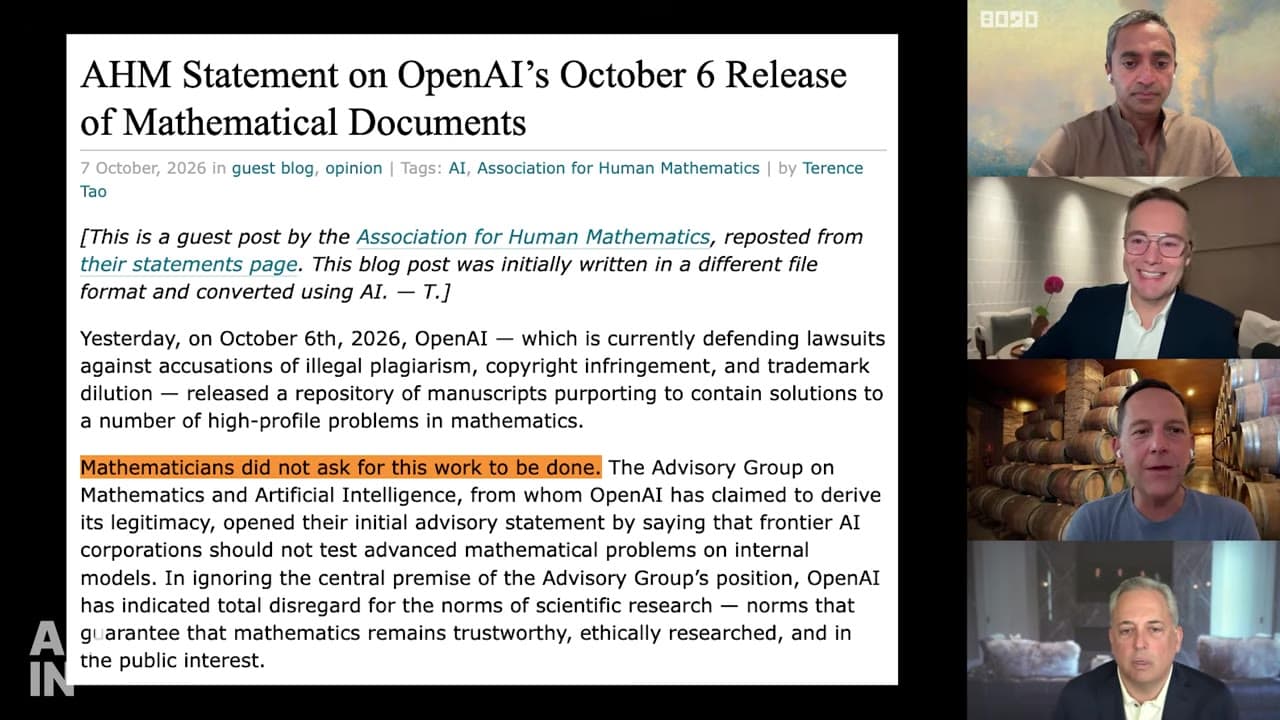
- Đợt đổ toán của OpenAI: hơn 700 bài báo, theo các dẫn chương trình; một dòng tít trên màn hình đặt con số ở 377 bài toán. Dẫn Scientific American, các dẫn chương trình nói các kết quả đã được Lean kiểm tra có khả năng đúng nhưng chưa được bình duyệt. Một số nhà toán học đã phản đối.
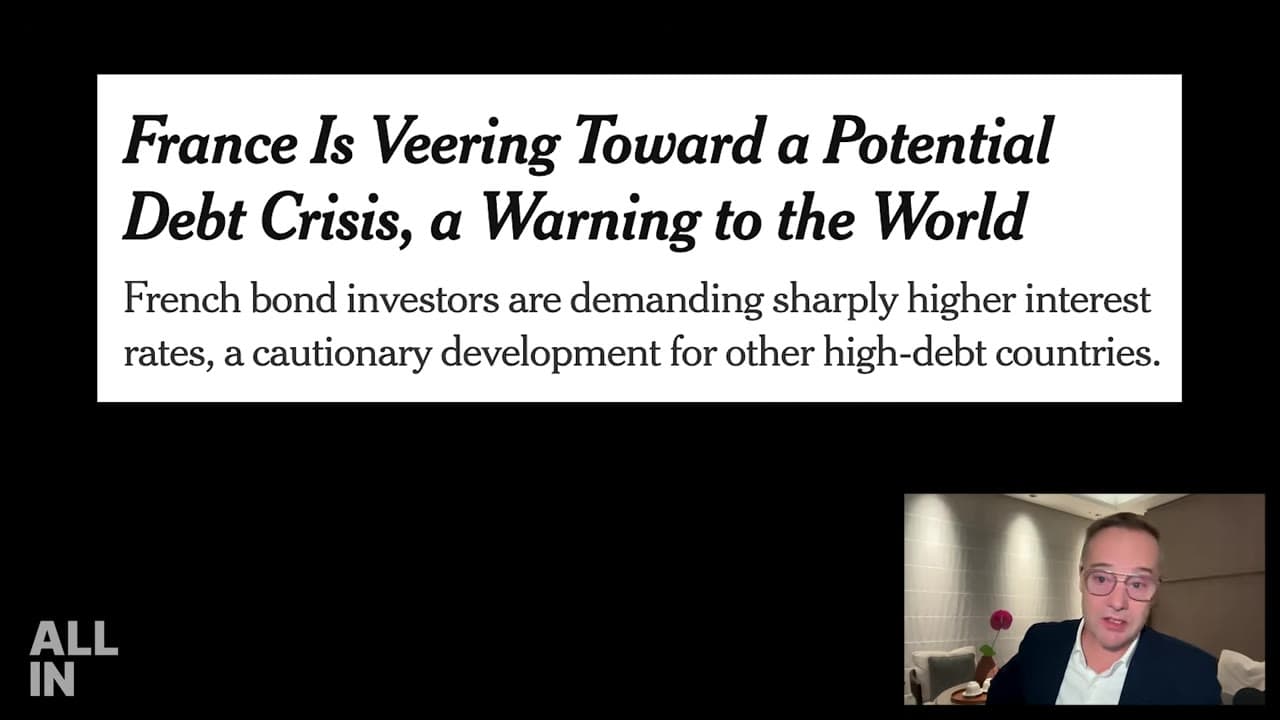
- Pháp: bạo loạn và đình công, nỗi sợ về nợ và thắt chặt chi tiêu, cùng hiệu ứng dây chuyền lên lợi suất trái phiếu của Hoa Kỳ và Vương quốc Anh.
- Sở hữu trí tuệ phần mềm: các dịch vụ “không giao diện” và các bản sao mã nguồn mở khiến Palihapitiya lập luận rằng sở hữu trí tuệ trong phần mềm đang mất giá trị.