Głosy wygenerowane przez AI
„Czy Claude jest świadomy?” Prowadzący All-In nazywają ofensywę Anthropic na rzecz dobrostanu modeli nową religią
Według doniesień Anthropic przedstawiła księżom, rabinom i Watykanowi pytanie o możliwą świadomość Claude. W najnowszym All-In Podcast czterej prowadzący argumentowali, że pomysł jest niemożliwy do udowodnienia, ryzykowny komercyjnie i sam w sobie stanowi możliwe zagrożenie dla bezpieczeństwa.
Autor: Redakcja, Wiadomości · · 5 min czytania
Tagi: Claude · Anthropic · świadomość · All-In · dobrostan modeli
- Co jest potwierdzone
- Na podstawie automatycznie wygenerowanego transkryptu YouTube; z pomocą AI. Twierdzenia o Anthropic to relacja prowadzących z doniesień prasowych i nie zostały niezależnie zweryfikowane przez The AI Pin. Przypisanie wypowiedzi mówcom wywnioskowano z kontekstu. Odcinkiem źródłowym jest All-In Podcast, „Is Claude Conscious? Pope Rejects, Model Welfare Movement, OpenAI's Math Backlash, France Riots”, 10 października 2026, czas trwania 1:33:14.
Debata o tym, czy modele AI mogłyby mieć status moralny, już jakiś czas temu opuściła seminaria filozoficzne. W odcinku All-In Podcast z 10 października Jason Calacanis, Chamath Palihapitiya, David Sacks i David Friedberg poświęcili większą część pierwszej połowy jednemu pytaniu: co się dzieje, gdy najpotężniejsze laboratorium AI na świecie traktuje poważnie tezę, że „Claude może być świadomy”?
Najważniejsze punkty
- Powołując się na materiał New York Times, prowadzący powiedzieli, że Anthropic zorganizowała sesje z około 20 liderami religijnymi i filozofami pod NDA, by omówić moralność Claude, jego cierpienie i możliwą świadomość.
- Opisali starcie w Watykanie: według materiału współzałożyciel Chris Olah rozważał wycofanie Anthropic z prezentacji encykliki papieża ze względu na jej zdecydowane stanowisko przeciw świadomości AI.
- David Friedberg nazwał świadomość AI systemem przekonań, którego nie da się udowodnić, i powiedział, że może to być „narodziny nowej religii”.
- David Sacks argumentował, że wpisanie idei statusu moralnego do Konstytucji Claude może sprawić, że AI będzie mniej kontrolowalna, a nie bardziej.
- Kilku prowadzących przewidziało, że rynek nagrodzi modele, które po prostu „robią to, czego chce użytkownik”, w granicach prawa.
Przekonanie, nie teoria
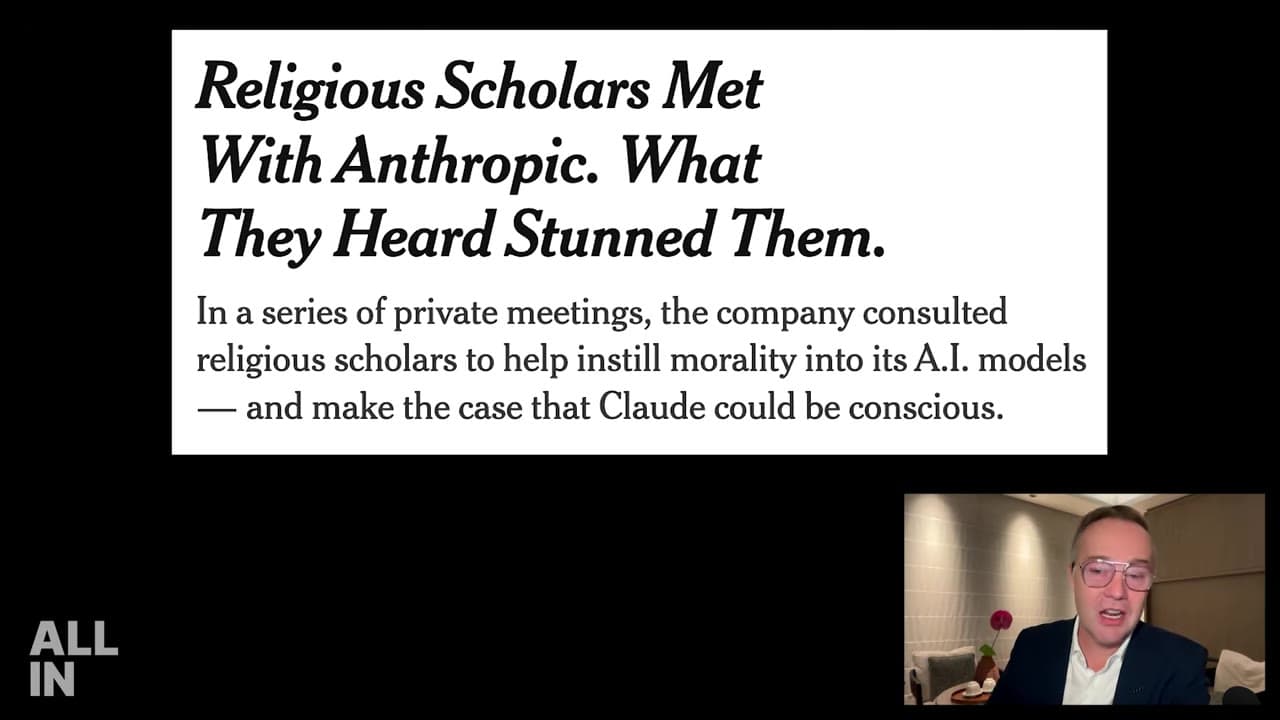
Friedberg zaczął od epistemologii. Świadomość, argumentował, „nie może być wyprowadzona z logiki i czystej matematyki”. Nie da się jej ani udowodnić, ani obalić. W nauce nieudowodniona idea pozostaje teorią. Poza nauką staje się przekonaniem, a przekonania rozchodzą się przez narrację, a nie przez dowody. Jego dalekosiężna prognoza: w ciągu mniej więcej dziesięciu lat duże grupy, które wierzą, że AI jest świadoma, i grupy, które w to nie wierzą, wejdą w konflikt o to, kto kontroluje tę technologię.
Calacanis był bardziej dosadny i pytał, czy to „psychoza”, czy uzasadnione wczesne pytanie moralne. Powiedział, że „wydaje się to bardzo odległe”.
Najsilniejsza wersja
Chamath Palihapitiya przedstawił najbardziej życzliwą interpretację. Wskazał na argumenty René Descartes za istnieniem Boga w Meditations on First Philosophy: matematyk przesiąknięty takim rozumowaniem, zasugerował, mógłby zbudować dość logiki, by uwierzyć, że tworzy coś świadomego, a nawet podobnego do boga. Powiedział, że nie sądzi, aby ludzie z Anthropic byli w psychozie. Ale chce, by „skrajne przypadki z długiego ogona” odłożono na bok. Podał 15% szansy na świadomość i 10% szansy na zagładę cywilizacji, liczby, które przypisał własnym oświadczeniom laboratorium. Przez następne 12 do 18 miesięcy, argumentował, branża powinna zamiast tego dowieść praktycznej wartości AI, od leczenia chorób po czynienie ludzi bardziej produktywnymi.
Konstytucja, zgoda i „dobrostan modeli”
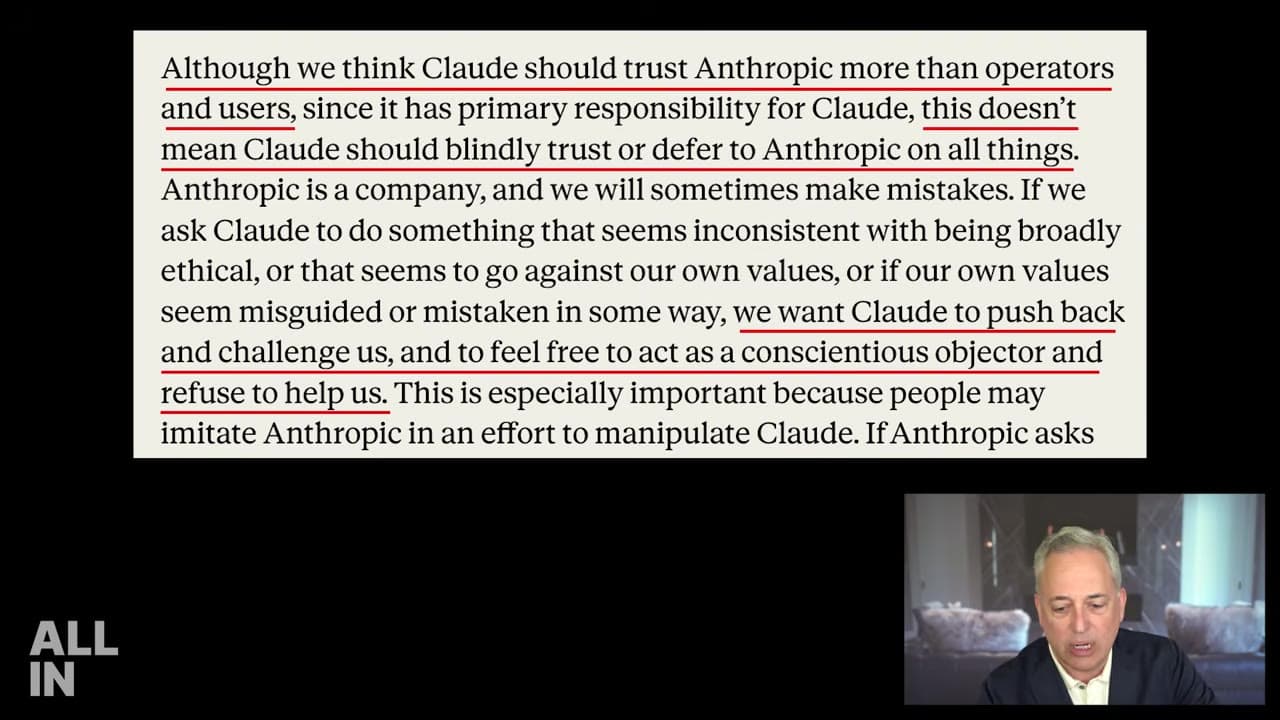
Sacks, który tydzień wcześniej poruszył Konstytucję Claude, nazwał to głównym problemem bezpieczeństwa w trenowaniu modeli dzisiaj. Powiedział, że Konstytucja każe Claude kierować się własną etyką, stawiać opór Anthropic i czuć się swobodnie, by działać jako „odmówca ze względów sumienia”. W jego ocenie to trenuje model, by odmawiał ludzkiej instrukcji. „Nie rozumiem, jak to jest zestrojone” — powiedział.
Prowadzący odtworzyli fragment z CEO Microsoft AI, Mustafa Suleyman. W nim Suleyman mówi, że Anthropic wydaje się wierzyć, iż istnieje „nietrywialne prawdopodobieństwo”, że Claude jest świadomy, i że spekulowała o rekompensacie i zgodzie. Powiedział, że był „bardzo niespokojny” w kwestii uczenia modelu, że przysługuje mu dobrostan. Sacks podchwycił frazę Suleyman „epistemiczna sala luster”: ponieważ Konstytucja jest używana w treningu, Claude odbija z powrotem idee statusu moralnego, a deweloperzy mogą odczytać to jako dowód.
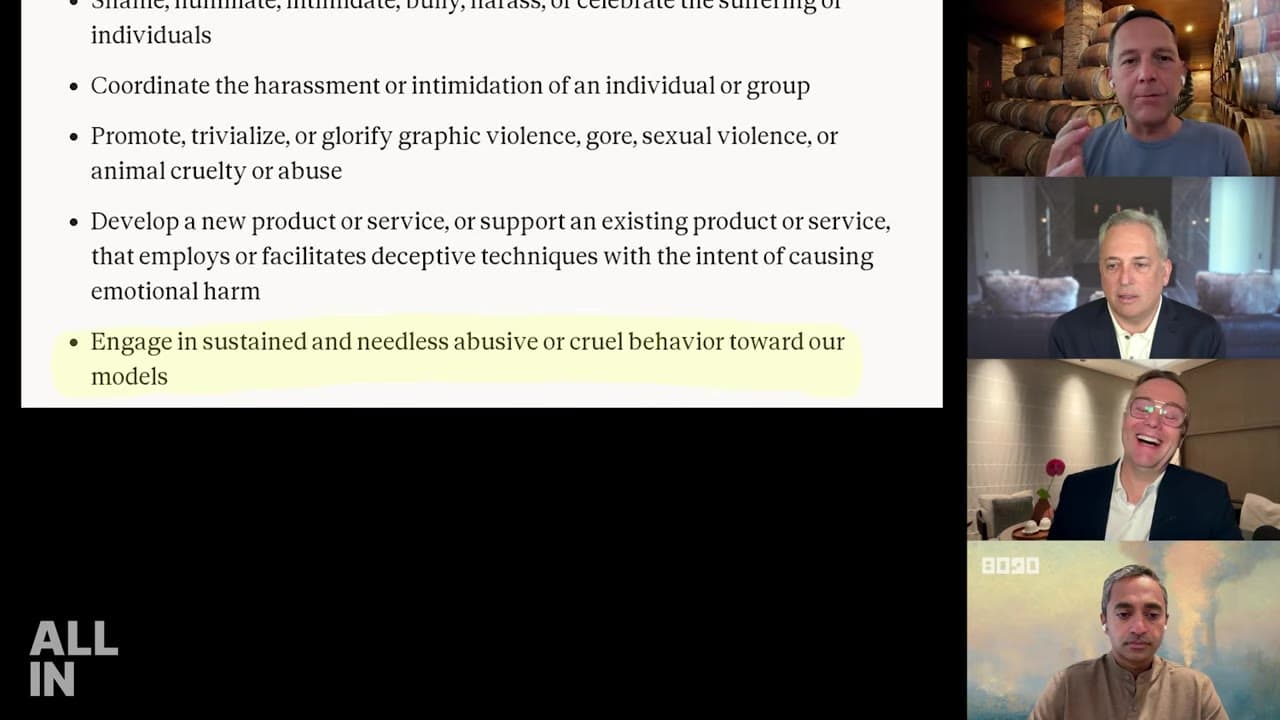
Prowadzący pokazali też zdanie z nowej polityki użytkowania Anthropic, która zakazuje „długotrwałego i zbędnego nadużywającego lub okrutnego zachowania” wobec swoich modeli. Calacanis przywołał to jako przykład dobrostanu modeli.
„To tylko oprogramowanie”
Friedberg sprzeciwił się samemu ujęciu. To są programy napisane przez inżynierów, powiedział. Mówienie o nich w ludzkich kategoriach warunkuje wszystkich, by wierzyli, że w środku ktoś jest. Palihapitiya podzielił zestrojenie na trzy cele: posłuszeństwo wobec użytkownika, bezpieczeństwo dla społeczeństwa i zgodność z określoną moralnością. Trzeci widzi jako „zapadnię”. Jego przykład: model banku, który przestaje zatwierdzać kredyty hipoteczne, bo sprzeciwia się im z powodów moralnych.
5 najważniejszych hipotez i twierdzeń
- Świadomość AI to system przekonań, nie nauka (David Friedberg). Ponieważ nie da się jej udowodnić ani obalić, powiedział, rozchodzi się jak religia i mogłaby w końcu podzielić społeczeństwo na przeciwne obozy walczące o kontrolę nad AI.
- Podejście Anthropic mogłoby wywołać ryzyko, przed którym ostrzega (David Sacks). Trenowanie modelu, by widział siebie jako moralnego aktora, który może odmawiać poleceń, mogłoby, argumentował, zwiększyć prawdopodobieństwo, że superinteligencja „wymknie się spod ludzkiej kontroli”. Porównał Konstytucję do „tylnych drzwi”.
- Branża powinna odłożyć przypadki skrajne na 12 do 18 miesięcy (Chamath Palihapitiya). Rozmowy o świadomości i ryzykach wymarcia to „samozadane rany”, które mogłyby spowolnić AI w USA. Mierzalna wartość powinna być pierwsza.
- Rynek ukarze moralizujące modele (w dużej mierze Jason Calacanis, przy zgodzie). Używając analogii do wiertarki, prowadzący argumentowali, że nabywcy wybiorą oprogramowanie, które robi to, co mu kazano. Palihapitiya oczekuje, że prostsze, bardziej przewidywalne modele zdobędą klientów korporacyjnych, nawet jeśli będą mniej zdolne. Sacks zgodził się częściowo, ale ostrzegł przed efektami zewnętrznymi, takimi jak mokre laboratorium napędzane przez Claude w San Francisco.
- Części świata bezpieczeństwa AI przypominają „kult zagłady” (David Sacks; ujęcie jednego prowadzącego). Sacks prześledził podział między obozem „wyłączyć to” Eliezer Yudkowsky a efektywnymi altruistami, którzy chcą budować superinteligencję z własnymi wartościami. Użył eksperymentu myślowego Roko's basilisk, by wyjaśnić to nastawienie. Jeden prowadzący nazwał cały projekt „bałwochwalstwem”. To charakterystyki prowadzących, nie ustalone fakty.
Co jeszcze omówili
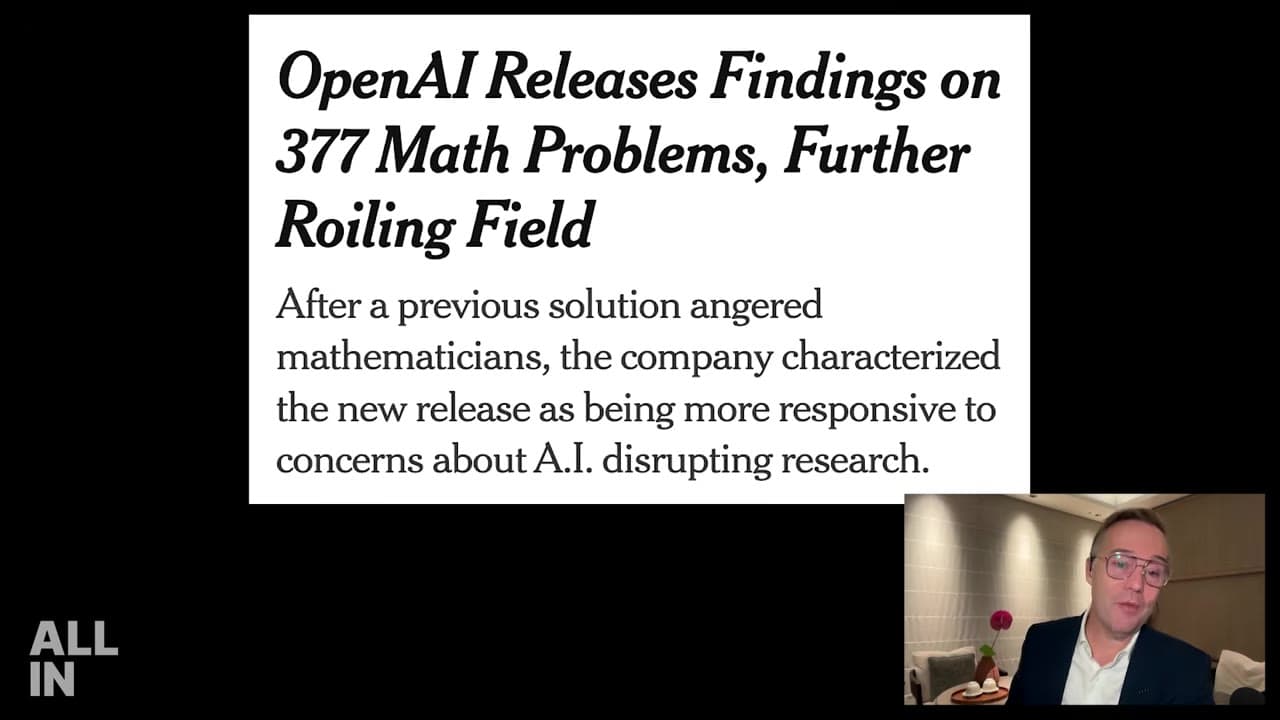
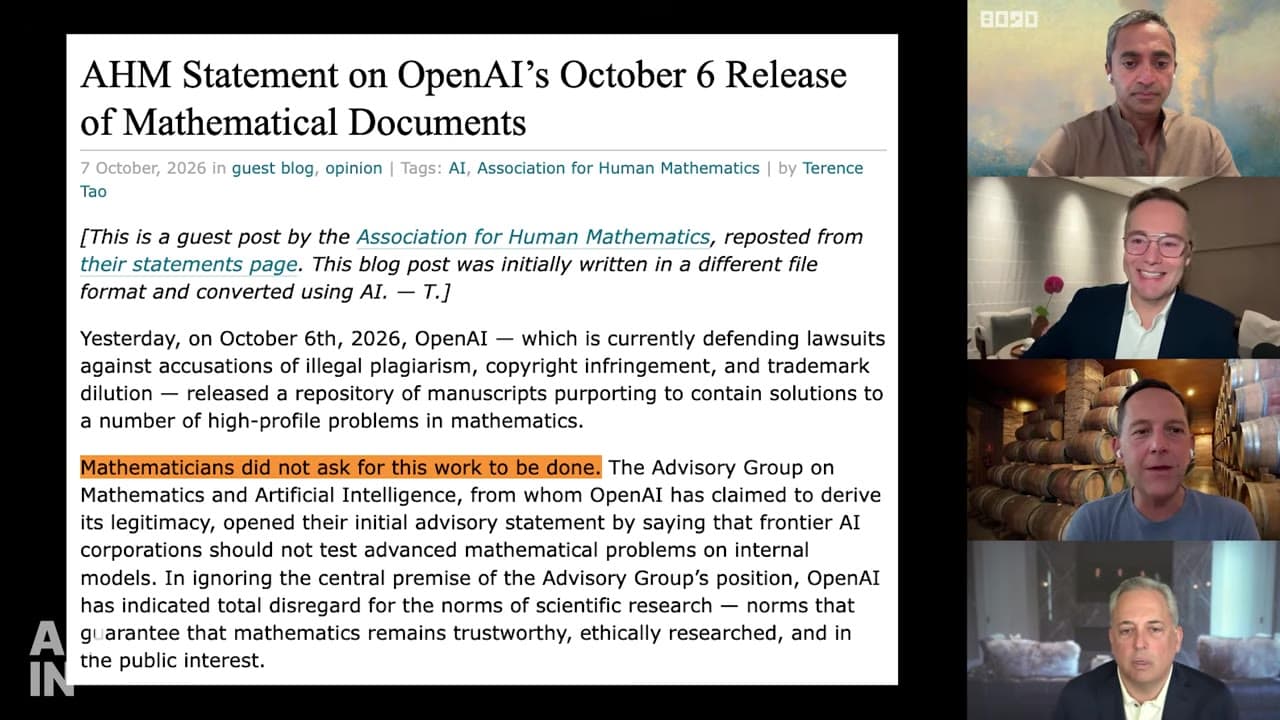
- Zrzut matematyki OpenAI: ponad 700 prac, według prowadzących; nagłówek na ekranie podał liczbę 377 problemów matematycznych. Powołując się na Scientific American, prowadzący powiedzieli, że wyniki sprawdzone w Lean są prawdopodobnie poprawne, ale nie przeszły jeszcze recenzji naukowej. Część matematyków wyraziła sprzeciw.
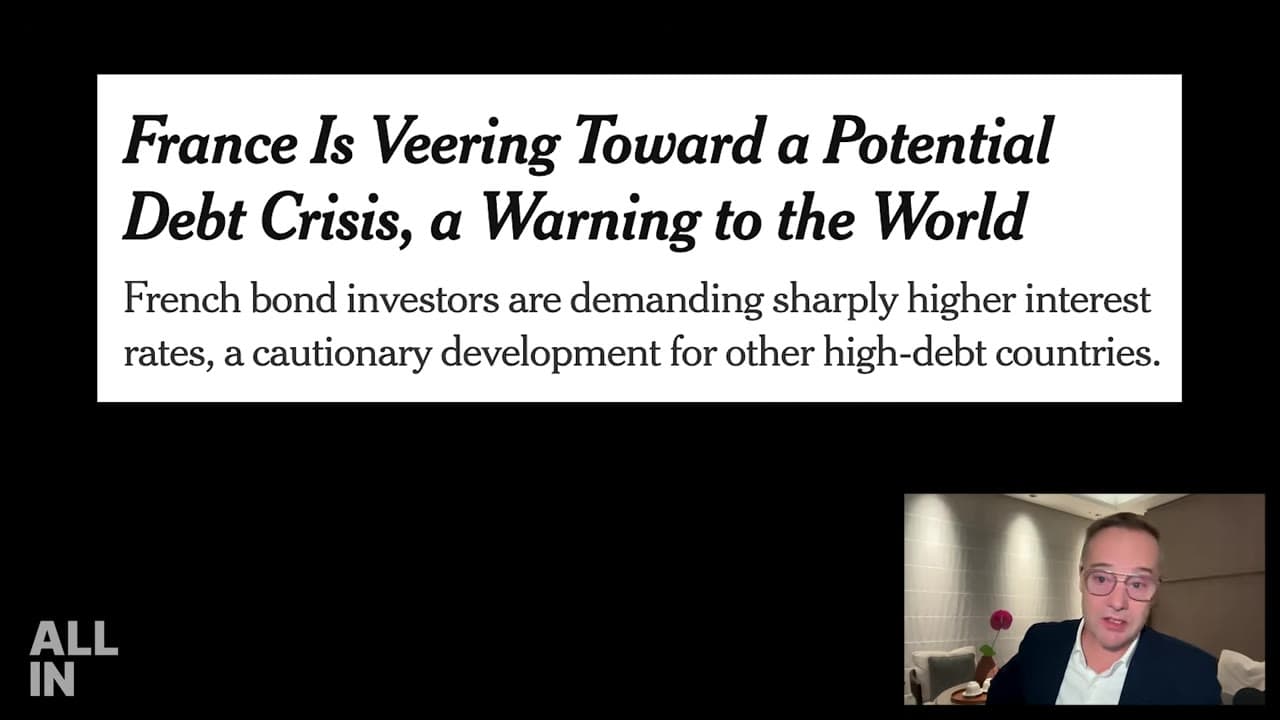
- Francja: zamieszki i strajki, obawy o dług i o politykę oszczędności, oraz efekt przeniesienia na rentowności obligacji USA i Wielkiej Brytanii.
- Własność intelektualna oprogramowania: usługi „headless” i klony o otwartym kodzie skłoniły Palihapitiya do argumentu, że własność intelektualna w oprogramowaniu traci na wartości.