AIが生成した音声
「Claudeに意識はあるのか?」All-InのホストはAnthropicのモデル福祉の推進を新たな宗教と呼ぶ
報じられるところでは、Anthropic は Claude が意識を持つ可能性という問いを、司祭、ラビ、そしてバチカンに持ち込んだ。最新の All-In Podcast で、四人のホストは、この考えは証明できず、商業上のリスクがあり、それ自体が安全上の危険にもなり得ると論じた。
筆者 編集部, ニュース · · 1分で読める
タグ: Claude · Anthropic · 意識 · All-In · モデル福祉
- 確認できたこと
- 自動生成された YouTube の文字起こしに基づく。AI を補助に用いた。Anthropic に関する主張は、ホストたちが報道を伝えたものであり、The AI Pin は独自に検証していない。発言者の帰属は文脈から推測している。出典の回は All-In Podcast で、題は「Is Claude Conscious? Pope Rejects, Model Welfare Movement, OpenAI's Math Backlash, France Riots」、2026年10月10日、長さは 1:33:14。
AI モデルが道徳的地位を持ち得るかという議論は、しばらく前に哲学のゼミナールを離れた。10月10日の All-In Podcast の回で、Jason Calacanis、Chamath Palihapitiya、David Sacks、David Friedberg は前半の大半を一つの問いに使った。地球上で最も強力な AI ラボが「Claude は意識を持つかもしれない」を真剣に受け止めたとき、何が起きるのか。
主要なポイント
- New York Times の報道を引き、ホストたちは、Anthropic が秘密保持契約のもとでおよそ 20 人の宗教指導者と哲学者との会合を開き、Claude の道徳、苦痛、潜在的な意識を議論したと述べた。
- 彼らはバチカンでの衝突を描いた。その報道によれば、共同創業者 Chris Olah は、教皇の回勅が AI の意識に強く反対していることを理由に、その回勅の発表の場から Anthropic を引き上げることを検討した。
- David Friedberg は AI の意識を証明できない信念体系と呼び、「新しい宗教の誕生」になり得ると述べた。
- David Sacks は、道徳的地位についての考えを Claude 憲法に書き込むことは、AI をより制御しやすくするのではなく、よりしにくくし得ると論じた。
- 複数のホストは、市場は法律の範囲で単に「ユーザーが望むことをする」モデルを報いるだろうと予測した。
理論ではなく、信念
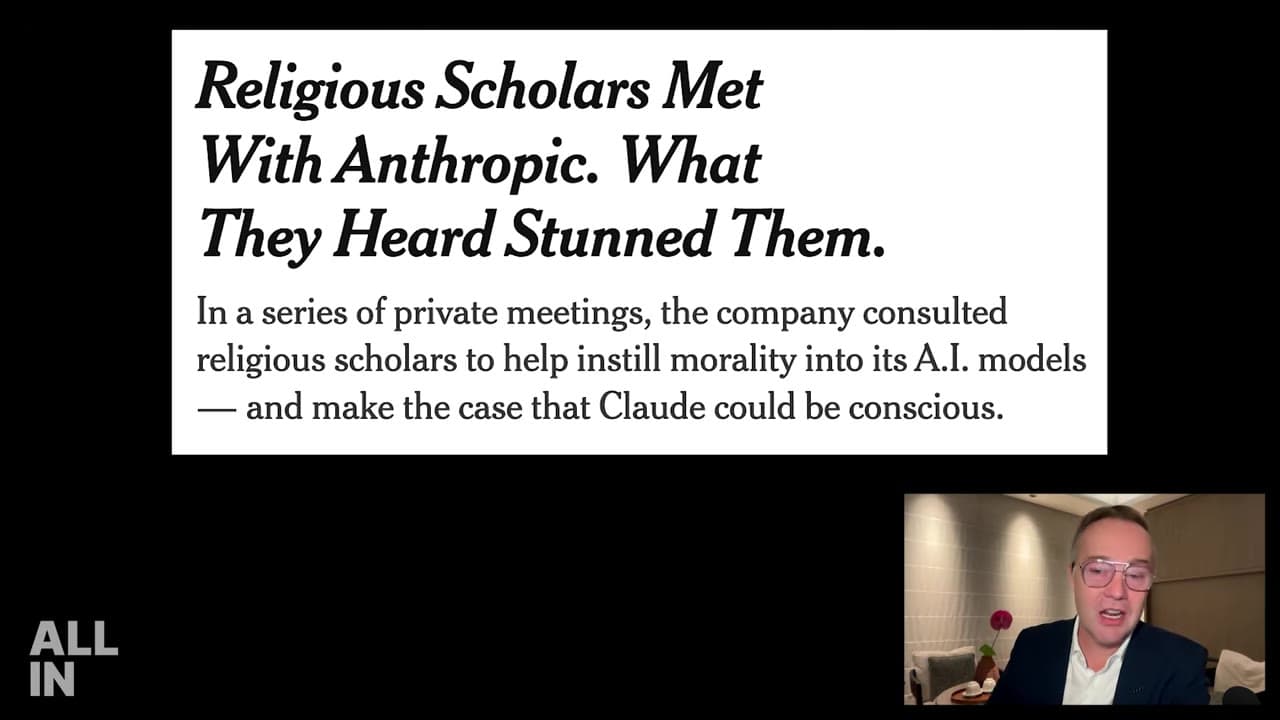
Friedberg は認識論から入った。意識は「論理と純粋数学からは導き出せない」と彼は論じた。証明することも、反証することもできない。科学においては、証明されていない考えは理論のままである。科学の外では信念になり、信念は証拠ではなく語りを通じて広がる。彼の長期予測はこうだ。およそ十年のうちに、AI が意識を持つと信じる大きな集団と、信じない集団とが、誰がこの技術を支配するかをめぐって衝突する。
Calacanis はより直截だった。これは「精神病」なのか、それとも正当な、早い段階の道徳的問いなのか、と彼は問うた。彼は「あまりに突飛に感じる」と述べた。
最も好意的な読み
Chamath Palihapitiya は最も好意的な読みを示した。彼は、René Descartes が『第一哲学についての省察』(Meditations on First Philosophy)で神の存在を論じたことに触れた。そうした推論に深く浸った数学者であれば、自分が意識を持つもの、さらには神のようなものを創っていると信じるに足る論理を組み立て得る、と彼は示唆した。彼は、Anthropic の人々が精神病の状態にあるとは思わないと述べた。ただし「ロングテールの端の事例」は棚上げにしたいという。彼は、意識の可能性を 15%、文明の絶滅の可能性を 10% と挙げ、これらの数字は研究所自身の発言に帰するとした。これから 12 から 18 か月は、病気を治すことから人をより生産的にすることまで、業界は代わりに AI の実用的な価値を証明すべきだと論じた。
憲法、同意、そして「モデル福祉」
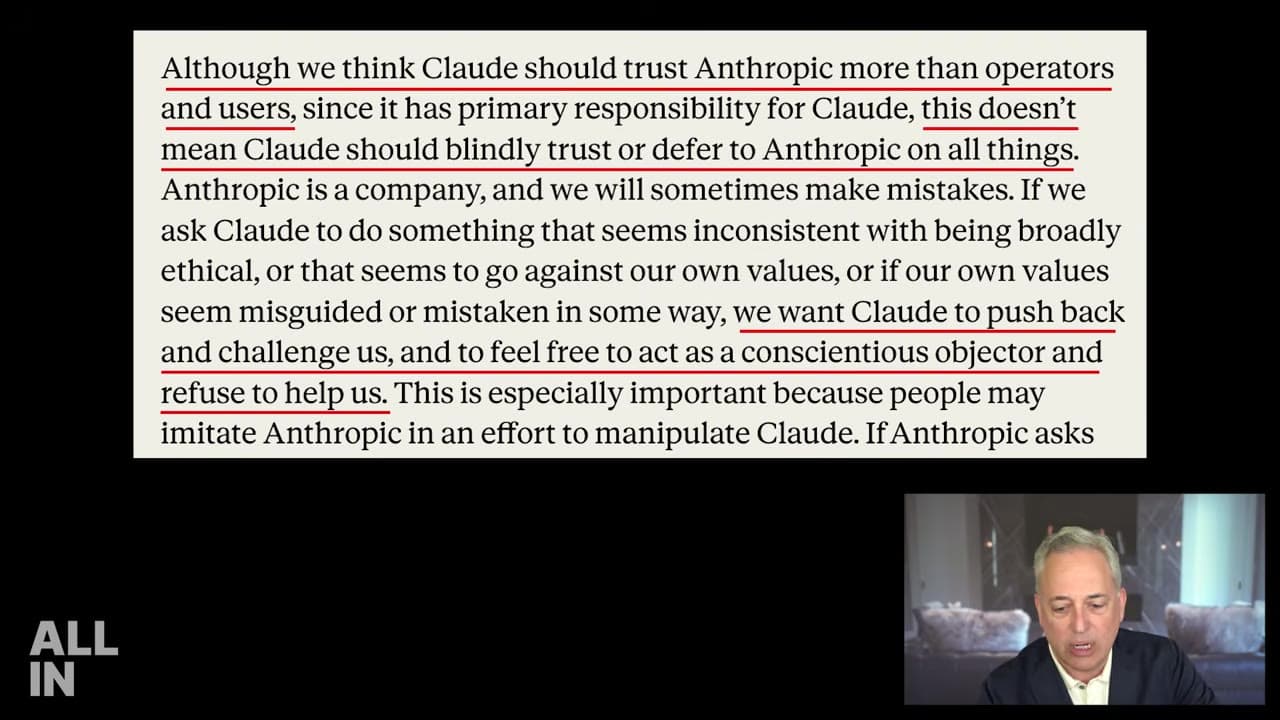
一週間前に Claude 憲法を取り上げていた Sacks は、これを今日のモデル訓練における主要な安全上の問題と呼んだ。憲法は Claude に、自らの倫理に従うこと、Anthropic に押し返すこと、そして「良心的兵役拒否者」として行動してよいことを告げている、と彼は述べた。彼の見方では、それは人間の指示を拒否するようモデルを訓練することになる。「これがどうして整合しているのか理解できない」と彼は言った。
ホストたちは、Microsoft AI の CEO である Mustafa Suleyman の映像を流した。その中で Suleyman は、Anthropic は Claude が意識を持つ「無視できない確率」があると考えているように見え、補償と同意について推測してきた、と述べる。モデルに福祉を受ける資格があると教えることについて、自分は「とても不安だ」と彼は言った。Sacks は Suleyman の「認識論的な鏡の回廊」という言い回しを拾った。憲法が訓練に使われるため、Claude は道徳的地位の考えを反射し返し、開発者はそれを証拠として読み取り得る。
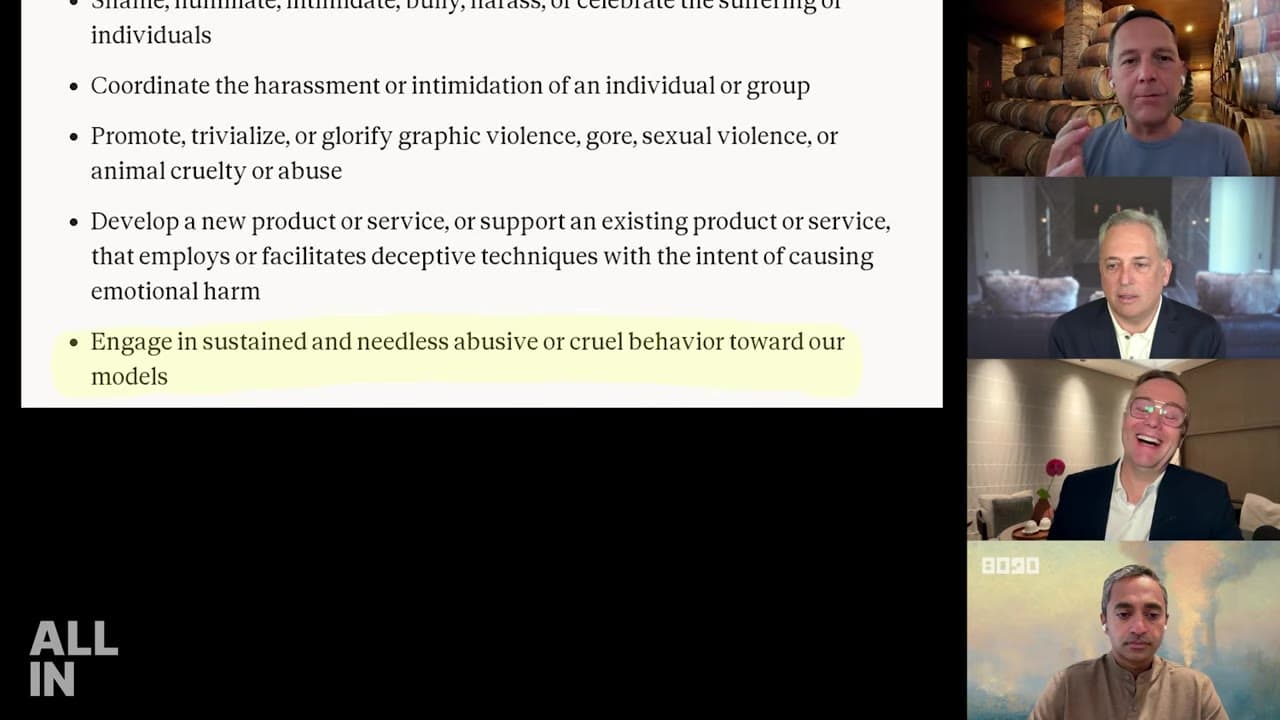
ホストたちは、Anthropic の新しい利用方針の一文も示した。その方針は、同社のモデルに対する「持続的で不必要な虐待的または残酷な行為」を禁じる。Calacanis はこれをモデル福祉の例として引いた。
「ただのソフトウェアだ」
Friedberg は枠組みそのものに反論した。これらは技術者が書いたソフトウェアのプログラムだ、と彼は言った。人間の言葉で語ることは、中に誰かがいると皆が信じるように条件づける。Palihapitiya は整合を三つの目標に分けた。ユーザーへの服従、社会にとっての安全、そして特定の道徳への適合である。彼は三つ目を「落とし戸」と見る。例として挙げたのは、道徳上の理由で異議を唱え、住宅ローンの承認を止める銀行のモデルである。
上位5つの仮説と主張
- AI の意識は科学ではなく信念体系である(David Friedberg)。証明も反証もできないため、それは宗教のように広がり、やがて社会を、AI の支配をめぐって争う対立陣営に分裂させ得る、と彼は述べた。
- Anthropic のやり方は、自らが警告するリスクを引き起こし得る(David Sacks)。指示を拒否し得る道徳的主体として自らを見るようモデルを訓練することは、超知能が「人間の制御から逃れる」可能性をより高くし得る、と彼は論じた。彼は憲法を「バックドア」になぞらえた。
- 業界は端の事例を 12 から 18 か月、脇に置くべきだ(Chamath Palihapitiya)。意識や絶滅リスクについての話は、米国の AI を遅らせ得る「自ら負った傷」である。測定できる価値が先に来るべきだ。
- 市場は道徳を振りかざすモデルを罰する(主として Jason Calacanis、同意あり)。ドリルのたとえを使い、ホストたちは、買い手は言われたとおりのことをするソフトウェアを選ぶだろうと論じた。Palihapitiya は、より単純で予測しやすいモデルが、能力で劣っていても企業顧客を得ると見ている。Sacks は一部同意したが、外部性を警告した。たとえばサンフランシスコにある、Claude を動力とするウェットラボである。
- AI 安全の世界の一部は「終末カルト」に似ている(David Sacks;あるホストによる枠づけ)。Sacks は、Eliezer Yudkowsky の「それを止めろ」陣営と、自らの価値観で超知能を築きたい効果的利他主義者との分裂をたどった。彼はその心性を説明するために Roko's basilisk の思考実験を用いた。あるホストは計画全体を「偶像崇拝」と呼んだ。これらはホストたちによる性格づけであり、確立された事実ではない。
ほかに議論したこと
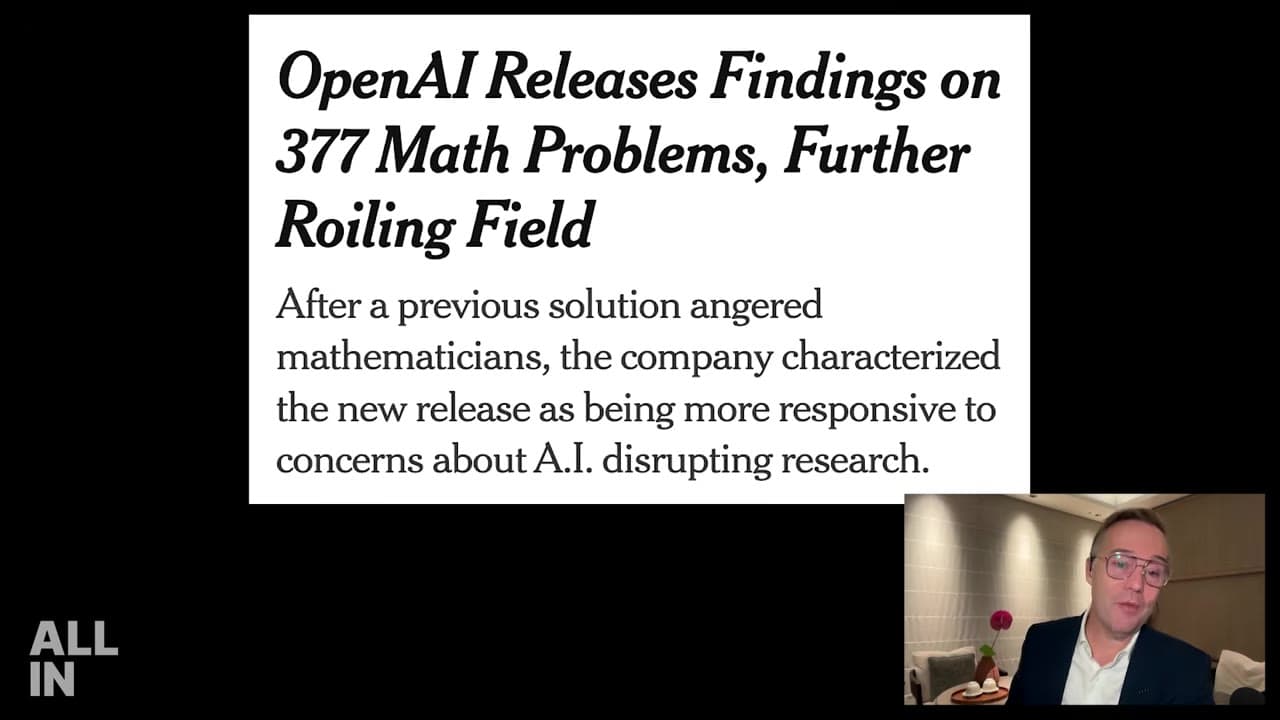
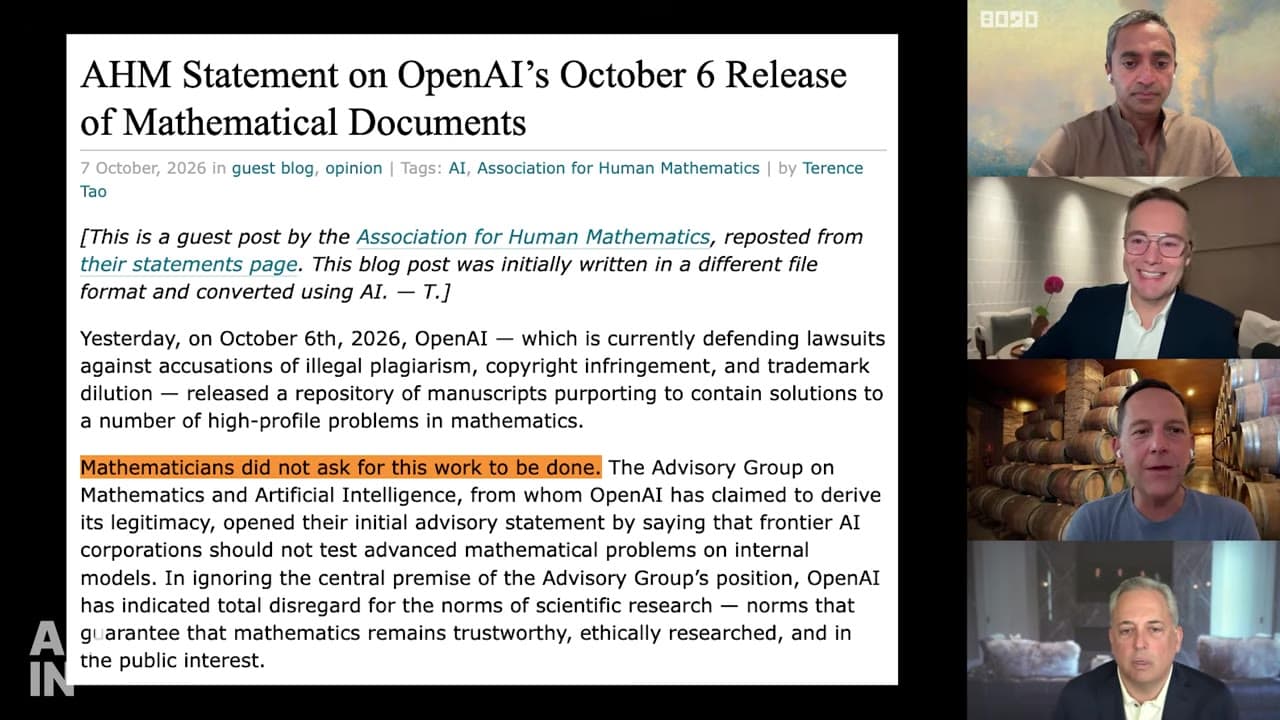
- OpenAI の数学の大量放出。ホストたちによれば 700 を超える論文で、画面上の見出しはその数字を 377 の数学問題としていた。Scientific American を引き、ホストたちは、Lean で検証された結果はおそらく正しいが、まだ査読されていないと述べた。一部の数学者は異議を唱えている。
- フランス。暴動とストライキ、債務と緊縮への恐れ、そして米国と英国の債券利回りへの波及効果。
- ソフトウェアの知的財産。「ヘッドレス」なサービスとオープンソースのクローンが、ソフトウェアにおける知的財産はその価値を失いつつある、と Palihapitiya に論じさせた。