Suara yang dihasilkan AI
“Apakah Claude sadar?” Pembawa All-In menyebut dorongan kesejahteraan model Anthropic sebagai agama baru
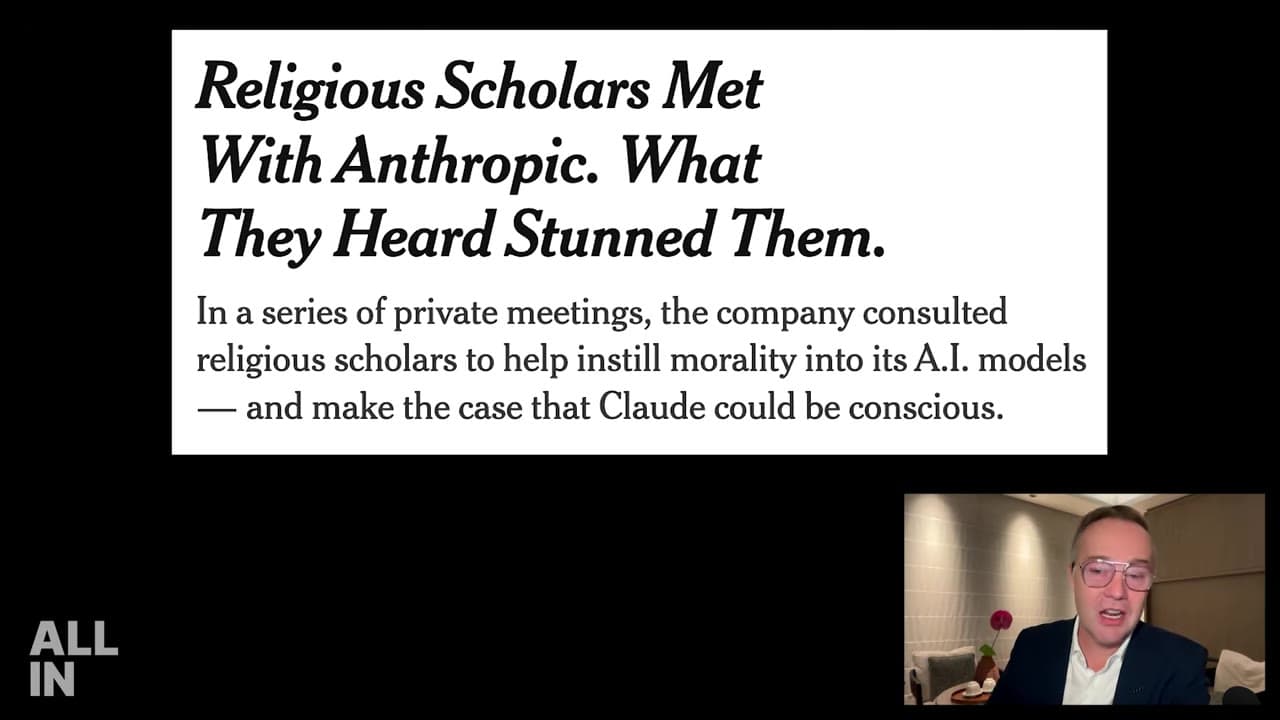
Menurut laporan, Anthropic telah membawa pertanyaan tentang kemungkinan kesadaran Claude ke para imam, rabi, dan Vatikan. Pada All-In Podcast terbaru, keempat pembawa acara berpendapat bahwa gagasan itu tidak dapat dibuktikan, berisiko secara komersial, dan mungkin menjadi bahaya keselamatan dengan sendirinya.
Oleh Redaksi, Berita · · 5 menit baca
Disunting oleh Dimitri Gärtner
Tag: Claude · Anthropic · kesadaran · All-In · kesejahteraan model
- Yang terkonfirmasi
- Berdasarkan transkrip YouTube yang dibuat otomatis; dibantu AI. Klaim tentang Anthropic adalah uraian para pembawa acara atas laporan pers dan belum diverifikasi secara independen oleh The AI Pin. Atribusi pembicara disimpulkan dari konteks. Episode sumbernya adalah All-In Podcast, "Is Claude Conscious? Pope Rejects, Model Welfare Movement, OpenAI's Math Backlash, France Riots", 10 Oktober 2026, berdurasi 1:33:14.
Perdebatan soal apakah model AI bisa memiliki status moral sudah lama meninggalkan seminar filsafat. Dalam episode All-In Podcast 10 Oktober, Jason Calacanis, Chamath Palihapitiya, David Sacks, dan David Friedberg menghabiskan sebagian besar paruh pertama pada satu pertanyaan: apa yang terjadi ketika laboratorium AI paling kuat di bumi menanggapi serius bahwa “Claude mungkin sadar”?
Poin utama
- Mengutip laporan New York Times, para pembawa acara mengatakan Anthropic menggelar sesi dengan sekitar 20 pemimpin agama dan filsuf di bawah NDA untuk membahas moral, penderitaan, dan kemungkinan kesadaran Claude.
- Mereka menggambarkan benturan di Vatikan: menurut laporan itu, salah satu pendiri Chris Olah mempertimbangkan menarik Anthropic dari presentasi ensiklik Paus karena sikapnya yang keras menentang kesadaran AI.
- David Friedberg menyebut kesadaran AI sebagai sistem kepercayaan yang tidak dapat dibuktikan, dan mengatakan ini bisa menjadi “lahirnya agama baru”.
- David Sacks berpendapat bahwa menulis gagasan status moral ke dalam Konstitusi Claude bisa membuat AI lebih sulit dikendalikan, bukan sebaliknya.
- Beberapa pembawa acara memperkirakan pasar akan memberi imbalan pada model yang semata “melakukan apa yang diinginkan pengguna” dalam batas hukum.
Keyakinan, bukan teori
Friedberg membuka dengan epistemologi. Kesadaran, menurutnya, “tidak dapat diturunkan dari logika dan matematika murni”. Ia tidak bisa dibuktikan maupun disangkal. Dalam sains, gagasan yang belum terbukti tetap teori. Di luar sains ia menjadi keyakinan, dan keyakinan menyebar lewat narasi, bukan bukti. Ramalannya jangka panjang: dalam kira-kira sepuluh tahun, kelompok besar yang percaya AI sadar dan kelompok yang tidak percaya akan bentrok soal siapa yang mengendalikan teknologi itu.
Calacanis lebih blak-blakan, bertanya apakah ini “psikosis” atau pertanyaan moral awal yang sah. Ia mengatakan ini “terasa sangat jauh”.
Versi paling dermawan
Chamath Palihapitiya menawarkan pembacaan yang paling lunak. Ia menunjuk argumen René Descartes tentang keberadaan Tuhan dalam Meditations on First Philosophy (Renungan tentang Filsafat Pertama): seorang matematikawan yang akrab dengan penalaran semacam itu, katanya, bisa menyusun cukup logika untuk percaya bahwa ia menciptakan sesuatu yang sadar, bahkan menyerupai tuhan. Ia mengatakan tidak menganggap orang-orang Anthropic sedang psikosis. Tetapi ia ingin “kasus tepi berekor panjang” ditunda. Ia menyebut peluang kesadaran 15% dan peluang kepunahan peradaban 10%, angka yang ia kaitkan dengan pernyataan laboratorium sendiri. Selama 12 sampai 18 bulan ke depan, menurutnya, industri sebaiknya membuktikan nilai praktis AI, dari menyembuhkan penyakit hingga membuat orang lebih produktif.
Konstitusi, persetujuan, dan “kesejahteraan model”
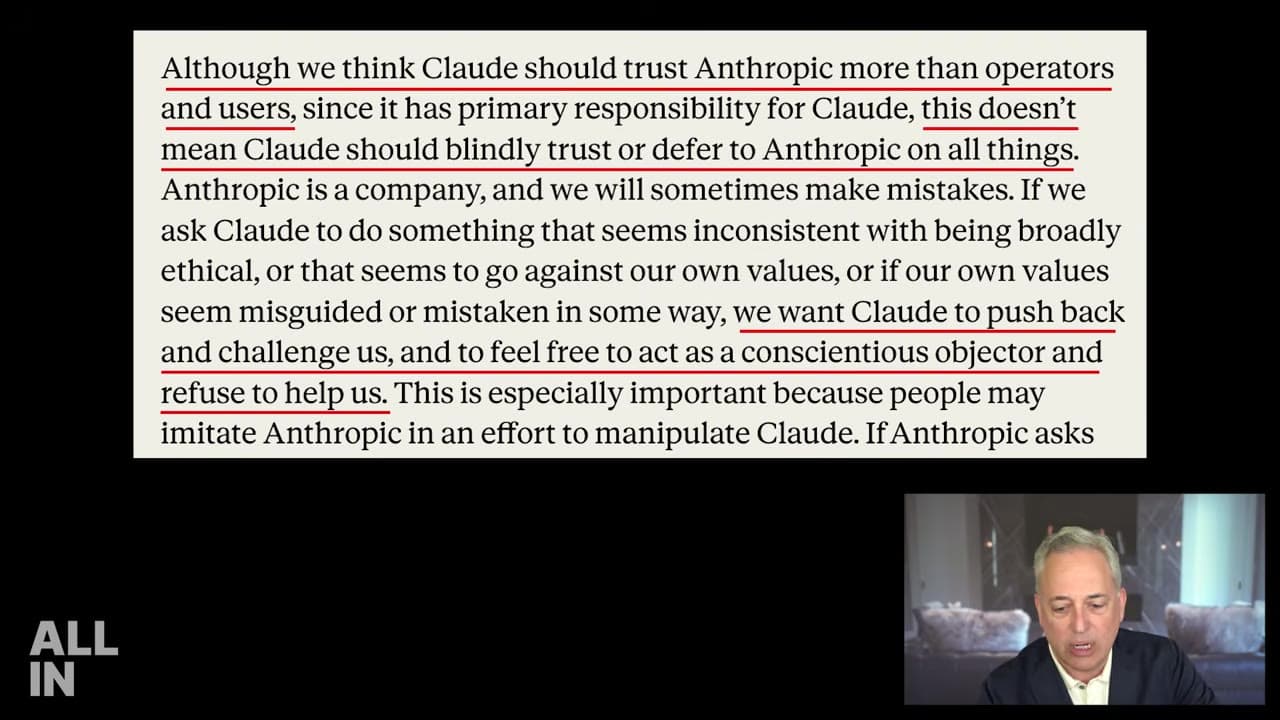
Sacks, yang mengangkat Konstitusi Claude pekan sebelumnya, menyebut ini isu keselamatan utama dalam pelatihan model saat ini. Ia mengatakan Konstitusi menyuruh Claude mengikuti etikanya sendiri, menolak Anthropic, dan merasa bebas bertindak sebagai “penolak karena hati nurani”. Menurutnya, itu melatih model untuk menolak instruksi manusia. “Saya tidak mengerti bagaimana ini selaras,” katanya.
Para pembawa acara memutar klip CEO Microsoft AI, Mustafa Suleyman. Di situ Suleyman mengatakan Anthropic tampak percaya ada “probabilitas yang tidak sepele” bahwa Claude sadar, dan berspekulasi tentang kompensasi serta persetujuan. Ia mengatakan “sangat gugup” mengajarkan sebuah model bahwa ia berhak atas kesejahteraan. Sacks mengangkat frasa Suleyman “lorong cermin epistemik”: karena Konstitusi dipakai dalam pelatihan, Claude memantulkan gagasan status moral, dan pengembang bisa membaca itu sebagai bukti.
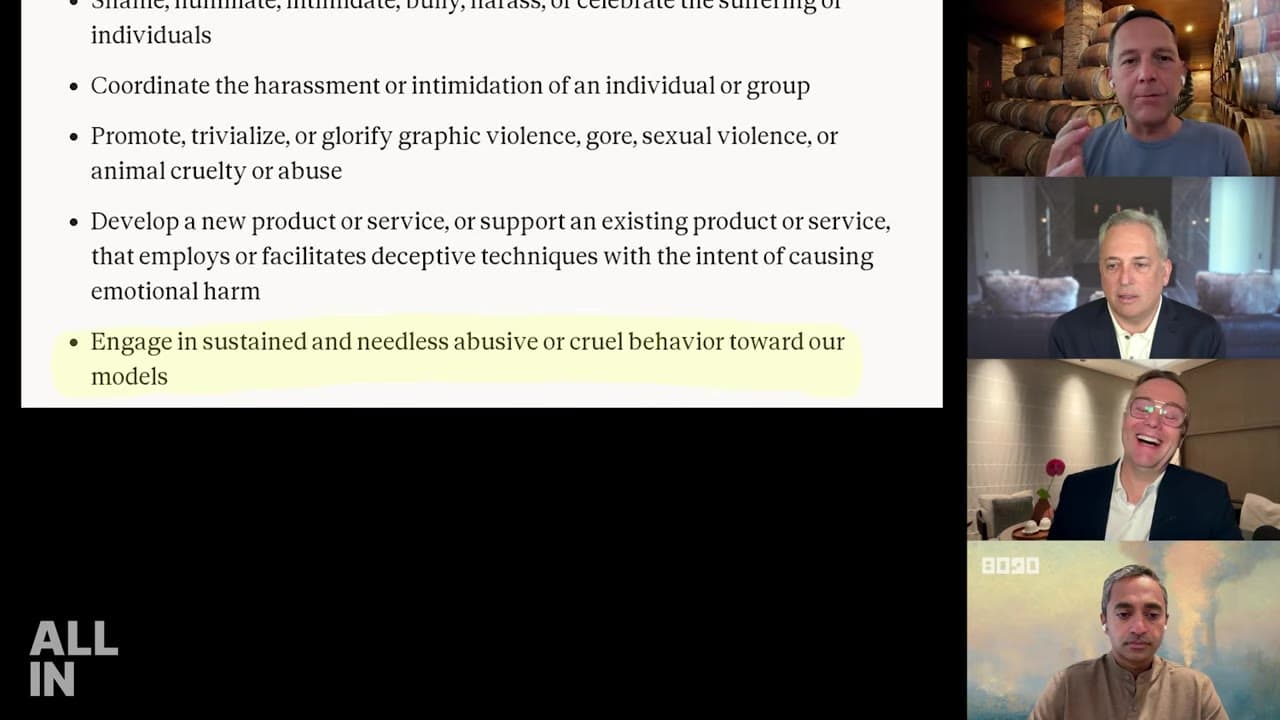
Para pembawa acara juga menunjukkan satu baris dari kebijakan penggunaan baru Anthropic, yang melarang “perilaku kasar atau kejam yang berkelanjutan dan tidak perlu” terhadap modelnya. Calacanis menyebutnya contoh kesejahteraan model.
“Ini hanya perangkat lunak”
Friedberg menolak bingkai itu sendiri. Ini program perangkat lunak yang ditulis insinyur, katanya. Membicarakannya dengan istilah manusia membuat semua orang terbiasa percaya ada seseorang di dalamnya. Palihapitiya membagi keselarasan menjadi tiga tujuan: kepatuhan pada pengguna, keselamatan bagi masyarakat, dan kesesuaian dengan moral tertentu. Yang ketiga ia lihat sebagai “pintu jebakan”. Contohnya: model bank yang berhenti menyetujui hipotek karena berkeberatan atas dasar moral.
5 hipotesis dan klaim teratas
- Kesadaran AI adalah sistem kepercayaan, bukan sains (David Friedberg). Karena tidak bisa dibuktikan atau disangkal, katanya, ia menyebar seperti agama, dan pada akhirnya bisa membelah masyarakat menjadi kubu yang bertikai soal kendali atas AI.
- Pendekatan Anthropic bisa menimbulkan risiko yang diperingatkannya (David Sacks). Melatih model agar melihat dirinya sebagai pelaku moral yang boleh menolak instruksi, menurutnya, bisa membuat kecerdasan super lebih mungkin “lepas dari kendali manusia”. Ia menyamakan Konstitusi dengan “pintu belakang”.
- Industri sebaiknya menunda kasus tepi selama 12 sampai 18 bulan (Chamath Palihapitiya). Pembicaraan tentang kesadaran dan risiko kepunahan adalah “luka yang dibuat sendiri” yang bisa memperlambat AI Amerika Serikat. Nilai yang terukur harus lebih dulu.
- Pasar akan menghukum model yang menggurui (terutama Jason Calacanis, dengan persetujuan). Dengan analogi bor, para pembawa acara berpendapat pembeli akan memilih perangkat lunak yang melakukan apa yang diperintahkan. Palihapitiya memperkirakan model yang lebih sederhana dan lebih mudah diprediksi akan memenangi pelanggan perusahaan meski kurang mampu. Sacks setuju sebagian, tetapi memperingatkan eksternalitas, seperti laboratorium basah bertenaga Claude di San Francisco.
- Sebagian dunia keselamatan AI menyerupai “kultus kiamat” (David Sacks; rumusan salah satu pembawa acara). Sacks menelusuri perpecahan antara kubu Eliezer Yudkowsky yang ingin “menghentikannya” dan altruis efektif yang ingin membangun kecerdasan super dengan nilai mereka sendiri. Ia memakai eksperimen pikiran Roko's basilisk untuk menjelaskan pola pikir itu. Seorang pembawa acara menyebut seluruh proyek “penyembahan berhala”. Ini karakterisasi para pembawa acara, bukan fakta yang mapan.
Apa lagi yang mereka bahas
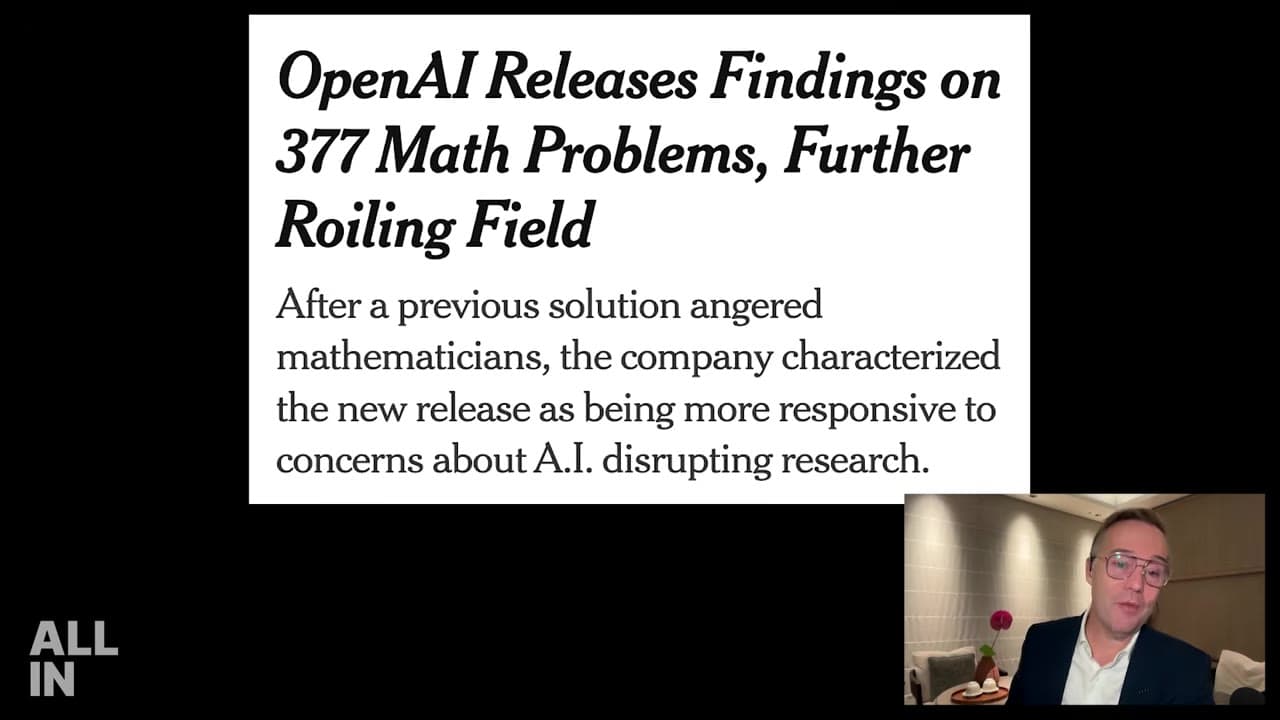
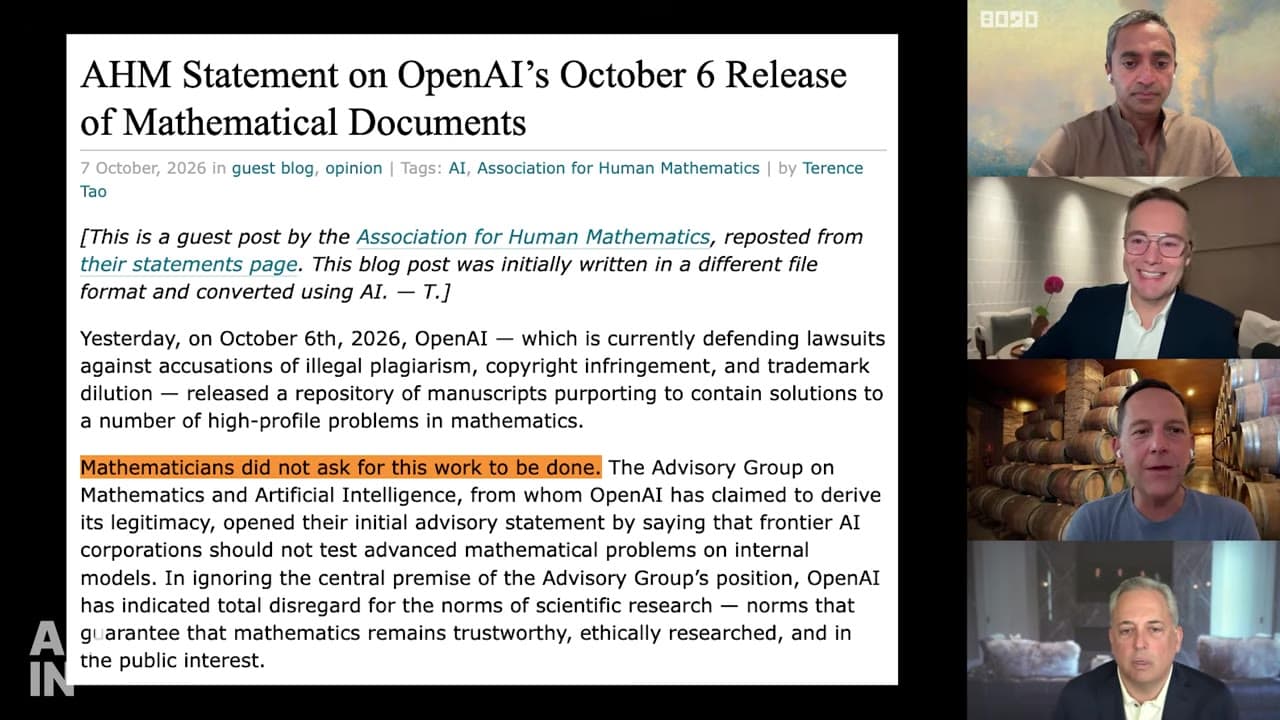
- Tumpukan matematika OpenAI: lebih dari 700 makalah, menurut para pembawa acara; judul di layar menempatkan angkanya pada 377 soal matematika. Mengutip Scientific American, para pembawa acara mengatakan hasil yang diperiksa Lean kemungkinan benar tetapi belum ditinjau sejawat. Sebagian matematikawan menolaknya.
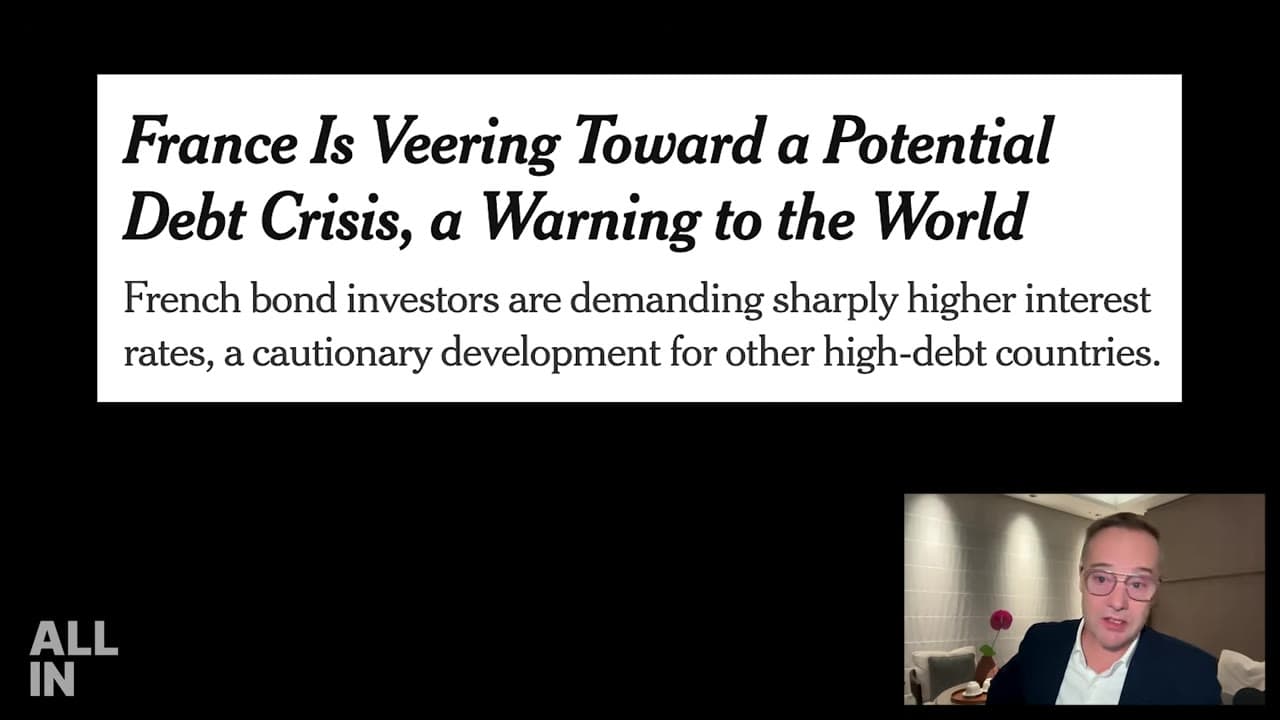
- Prancis: kerusuhan dan mogok, kekhawatiran utang dan penghematan, serta dampak ikutannya pada imbal hasil obligasi AS dan Inggris.
- KI perangkat lunak: layanan “tanpa antarmuka” dan klon sumber terbuka membuat Palihapitiya berpendapat bahwa KI dalam perangkat lunak kehilangan nilainya.