एआई से बनी आवाज़ें
“क्या Claude सचेत है?” All-In के होस्ट Anthropic के मॉडल-कल्याण अभियान को नया धर्म कहते हैं
रिपोर्टों के अनुसार Anthropic ने Claude की संभावित चेतना का सवाल पादरियों, रबियों और वेटिकन के सामने रखा है। ताज़ा All-In Podcast में चारों होस्टों ने दलील दी कि यह विचार अप्रमाणित है, व्यावसायिक रूप से जोखिम भरा है, और अपने आप में एक सुरक्षा खतरा हो सकता है।
संपादकीय द्वारा, समाचार · · 6 मिनट का पठन
चिह्न: Claude · Anthropic · चेतना · All-In · मॉडल कल्याण
- जो पुष्ट है
- YouTube की स्वतः बनी प्रतिलिपि पर आधारित; एआई की सहायता से। Anthropic के बारे में दावे होस्टों द्वारा प्रेस रिपोर्टों का बयान हैं और The AI Pin ने उन्हें स्वतंत्र रूप से सत्यापित नहीं किया है। वक्ता का अनुमान संदर्भ से लगाया गया है। स्रोत एपिसोड All-In Podcast है, "Is Claude Conscious? Pope Rejects, Model Welfare Movement, OpenAI's Math Backlash, France Riots", 10 अक्टूबर 2026, अवधि 1:33:14।
इस बहस ने कि एआई मॉडल का नैतिक दर्जा हो सकता है या नहीं, दर्शन की कक्षाएँ कुछ समय पहले छोड़ दीं। All-In Podcast के 10 अक्टूबर एपिसोड में Jason Calacanis, Chamath Palihapitiya, David Sacks और David Friedberg ने पहले आधे का अधिकांश एक सवाल पर बिताया: जब धरती की सबसे ताकतवर एआई प्रयोगशाला “Claude शायद सचेत है” को गंभीरता से लेती है, तब क्या होता है?
मुख्य बातें
- New York Times की एक रिपोर्ट का हवाला देते हुए होस्टों ने कहा कि Anthropic ने NDA के तहत करीब 20 धार्मिक नेताओं और दार्शनिकों के साथ सत्र रखे, ताकि Claude की नैतिकता, पीड़ा और संभावित चेतना पर बात हो।
- उन्होंने वेटिकन में एक टकराव बताया: रिपोर्ट के अनुसार सह-संस्थापक Chris Olah ने पोप के विश्वपत्र की प्रस्तुति से Anthropic को वापस लेने पर विचार किया, क्योंकि उसमें एआई चेतना के खिलाफ कड़ा रुख था।
- David Friedberg ने एआई चेतना को एक अप्रमाणित विश्वास-व्यवस्था कहा, और कहा कि यह “एक नए धर्म का जन्म” बन सकती है।
- David Sacks ने दलील दी कि नैतिक दर्जे के विचार Claude के संविधान में लिखने से एआई कम नियंत्रित हो सकता है, अधिक नहीं।
- कई होस्टों ने अनुमान लगाया कि बाज़ार उन मॉडलों को इनाम देगा जो कानून के भीतर बस “वह करें जो उपयोगकर्ता चाहता है”।
विश्वास, सिद्धांत नहीं
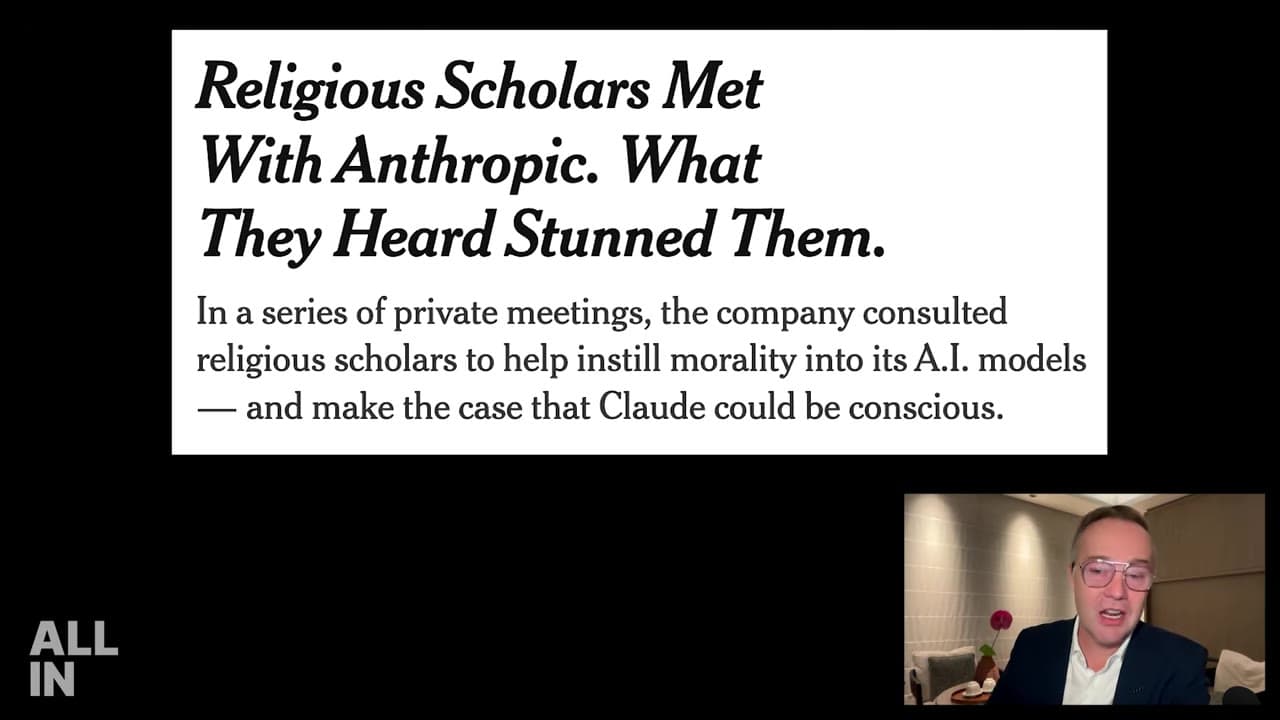
Friedberg ने ज्ञानमीमांसा से शुरुआत की। चेतना, उनकी दलील थी, “तर्क और शुद्ध गणित से निकाली नहीं जा सकती”। उसे न सिद्ध किया जा सकता है, न खारिज। विज्ञान में अप्रमाणित विचार सिद्धांत रहता है। विज्ञान के बाहर वह विश्वास बन जाता है, और विश्वास प्रमाण से नहीं, कथा से फैलते हैं। उनका दूर का अनुमान: करीब दस वर्षों में, एआई को सचेत मानने वाले बड़े समूह और न मानने वाले समूह इस तकनीक के नियंत्रण को लेकर टकराएँगे।
Calacanis अधिक सीधे थे। उन्होंने पूछा कि यह “मनोविकृति” है या एक वैध शुरुआती नैतिक सवाल। उन्होंने कहा कि यह “बहुत दूर की बात लगती है”।
सबसे उदार पढ़ाई
Chamath Palihapitiya ने सबसे उदार व्याख्या दी। उन्होंने Meditations on First Philosophy (प्रथम दर्शन पर ध्यान) में ईश्वर के अस्तित्व के लिए René Descartes के तर्कों की ओर इशारा किया: ऐसे तर्क में डूबा गणितज्ञ, उन्होंने सुझाया, इतना तर्क खड़ा कर सकता है कि उसे लगे वह कुछ सचेत, यहाँ तक कि ईश्वर-सदृश, बना रहा है। उन्होंने कहा कि उन्हें नहीं लगता Anthropic के लोग मनोविकृति में हैं। लेकिन वे “लंबी पूँछ वाले किनारे के मामले” टालना चाहते हैं। उन्होंने चेतना की 15% संभावना और सभ्यता के विलुप्त होने की 10% संभावना का हवाला दिया, और ये आँकड़े प्रयोगशाला के अपने बयानों से जोड़े। अगले 12 से 18 महीनों में, उनकी दलील थी, उद्योग को बीमारी के इलाज से लेकर लोगों को अधिक उत्पादक बनाने तक एआई का व्यावहारिक मूल्य दिखाना चाहिए।
संविधान, सहमति और “मॉडल कल्याण”
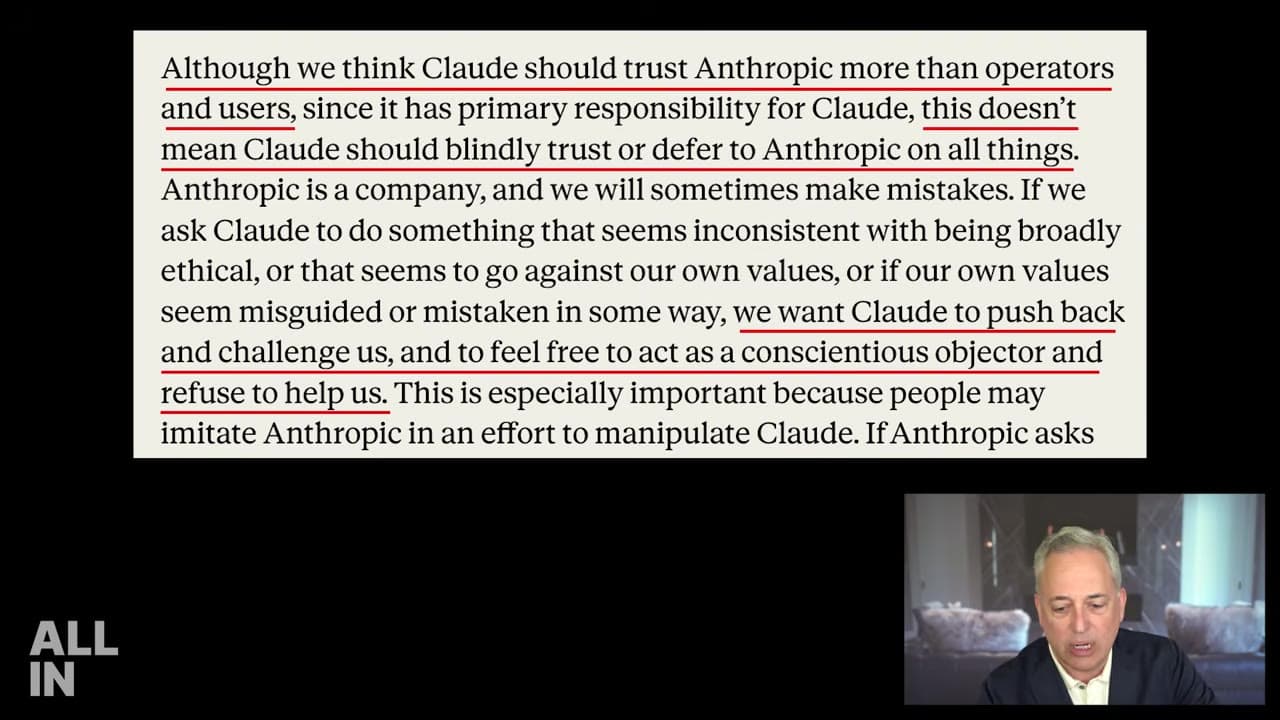
Sacks, जिन्होंने पिछले हफ्ते Claude का संविधान उठाया था, इसे आज मॉडल प्रशिक्षण में मुख्य सुरक्षा मुद्दा बताते हैं। उन्होंने कहा कि संविधान Claude से अपनी नैतिकता मानने, Anthropic का विरोध करने और “अंतरात्मा का आपत्तिकर्ता” बनने की छूट लेने को कहता है। उनके विचार में यह मॉडल को मानव निर्देश ठुकराना सिखाता है। उन्होंने कहा, “मुझे समझ नहीं आता यह संरेखित कैसे है।”
होस्टों ने Microsoft AI के सीईओ Mustafa Suleyman की एक क्लिप चलाई। उसमें Suleyman कहते हैं कि Anthropic को लगता दिखता है कि Claude के सचेत होने की “गैर-नगण्य संभावना” है, और उन्होंने मुआवज़े व सहमति पर अटकलें लगाई हैं। उन्होंने कहा कि मॉडल को यह सिखाना कि वह कल्याण का हकदार है, उन्हें “बहुत घबराहट” देता है। Sacks ने Suleyman का मुहावरा “ज्ञान का दर्पण-भूलभुलैया” उठाया: क्योंकि संविधान प्रशिक्षण में इस्तेमाल होता है, Claude नैतिक दर्जे के विचार वापस दर्शाता है, और डेवलपर उसे प्रमाण पढ़ सकते हैं।
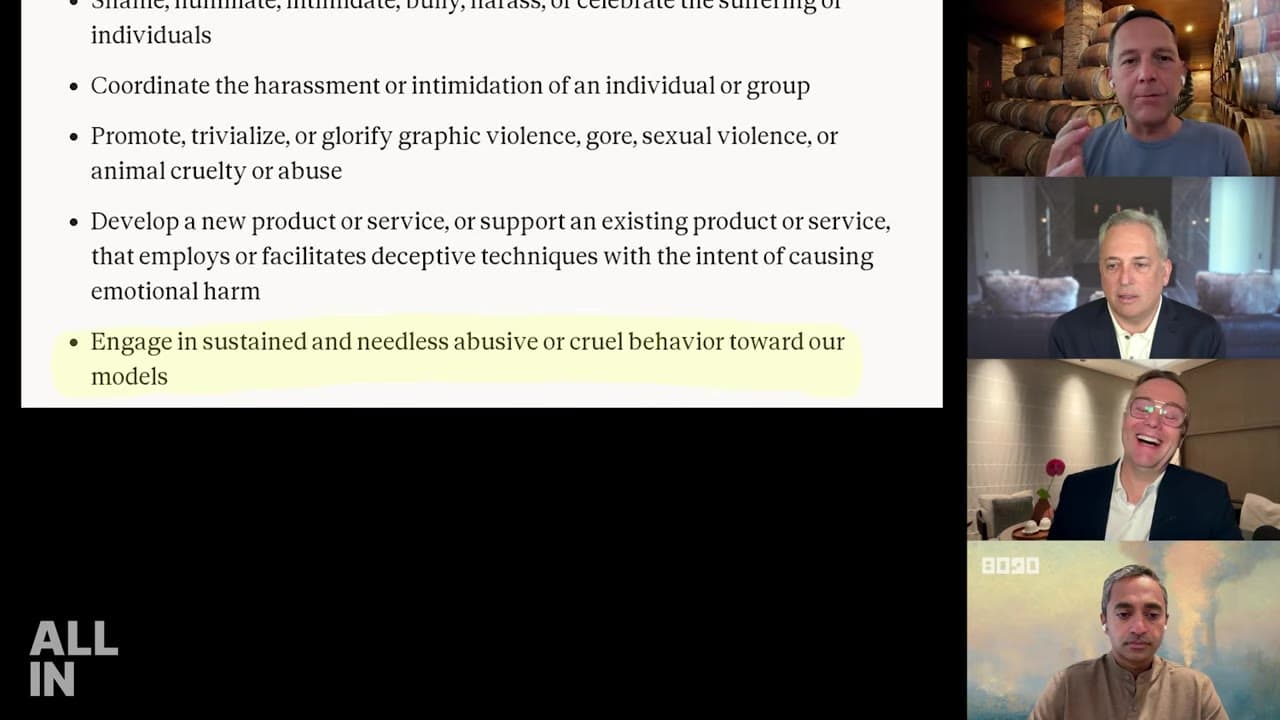
होस्टों ने Anthropic की नई उपयोग नीति की एक पंक्ति भी दिखाई, जो उसके मॉडलों के प्रति “लगातार और अनावश्यक अपमानजनक या क्रूर व्यवहार” रोकती है। Calacanis ने इसे मॉडल कल्याण का उदाहरण बताया।
“यह केवल सॉफ़्टवेयर है”
Friedberg ने इस ढाँचे पर ही आपत्ति की। ये इंजीनियरों द्वारा लिखे सॉफ़्टवेयर प्रोग्राम हैं, उन्होंने कहा। इनकी मानवीय भाषा में बात करना सबको यह मानने का आदी बनाता है कि भीतर कोई है। Palihapitiya ने संरेखण को तीन लक्ष्यों में बाँटा: उपयोगकर्ता की आज्ञा, समाज की सुरक्षा, और किसी खास नैतिकता के अनुरूप होना। तीसरे को वे “छिपा जाल” मानते हैं। उनका उदाहरण: बैंक का मॉडल जो नैतिक आपत्ति पर गिरवी मंज़ूर करना बंद कर दे।
शीर्ष 5 परिकल्पनाएँ और दावे
- एआई चेतना एक विश्वास-व्यवस्था है, विज्ञान नहीं (David Friedberg)। क्योंकि इसे सिद्ध या खारिज नहीं किया जा सकता, उन्होंने कहा, यह धर्म की तरह फैलती है, और अंततः समाज को एआई के नियंत्रण पर लड़ते विरोधी खेमों में बाँट सकती है।
- Anthropic का तरीका उसी जोखिम को जन्म दे सकता है जिससे वह चेताती है (David Sacks)। मॉडल को यह सिखाना कि वह एक नैतिक कर्ता है जो निर्देश ठुकरा सकता है, उनकी दलील थी, इस संभावना को बढ़ा सकता है कि अति-बुद्धि “मानव नियंत्रण से निकल जाए”। उन्होंने संविधान को “पिछला दरवाज़ा” कहा।
- उद्योग को किनारे के मामलों को 12 से 18 महीने के लिए टाल देना चाहिए (Chamath Palihapitiya)। चेतना और विलुप्ति के जोखिम की बात “स्वयं लगाए घाव” हैं जो अमेरिकी एआई को धीमा कर सकते हैं। मापने योग्य मूल्य पहले आना चाहिए।
- बाज़ार उपदेश देने वाले मॉडलों को सज़ा देगा (मुख्यतः Jason Calacanis, सहमति के साथ)। ड्रिल की उपमा देते हुए होस्टों ने कहा कि खरीदार वह सॉफ़्टवेयर चुनेंगे जो कहा मानता है। Palihapitiya को उम्मीद है कि सरल, अधिक अनुमान लगाने योग्य मॉडल एंटरप्राइज़ ग्राहक जीतेंगे, भले कम सक्षम हों। Sacks आंशिक रूप से सहमत थे, पर बाहरी प्रभावों की चेतावनी दी, जैसे San Francisco में Claude से चलने वाली वेट लैब।
- एआई-सुरक्षा जगत के कुछ हिस्से “प्रलय पंथ” जैसे हैं (David Sacks; एक होस्ट की शब्दावली)। Sacks ने Eliezer Yudkowsky के “इसे बंद करो” खेमे और उन प्रभावी परोपकारियों के बीच फूट बताई जो अपनी मूल्यों के साथ अति-बुद्धि बनाना चाहते हैं। उन्होंने इस मानसिकता को समझाने के लिए Roko's basilisk विचार-प्रयोग का इस्तेमाल किया। एक होस्ट ने पूरे प्रोजेक्ट को “मूर्तिपूजा” कहा। ये होस्टों के चरित्र-चित्रण हैं, स्थापित तथ्य नहीं।
उन्होंने और क्या चर्चा की
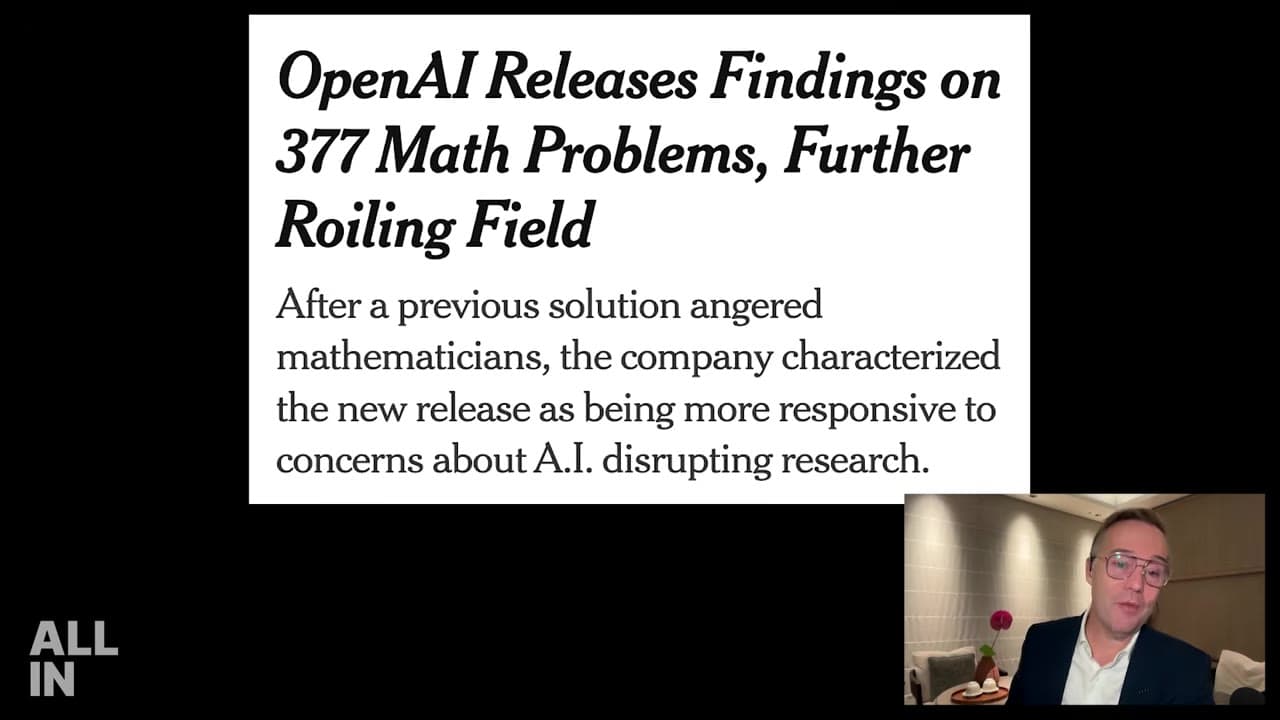
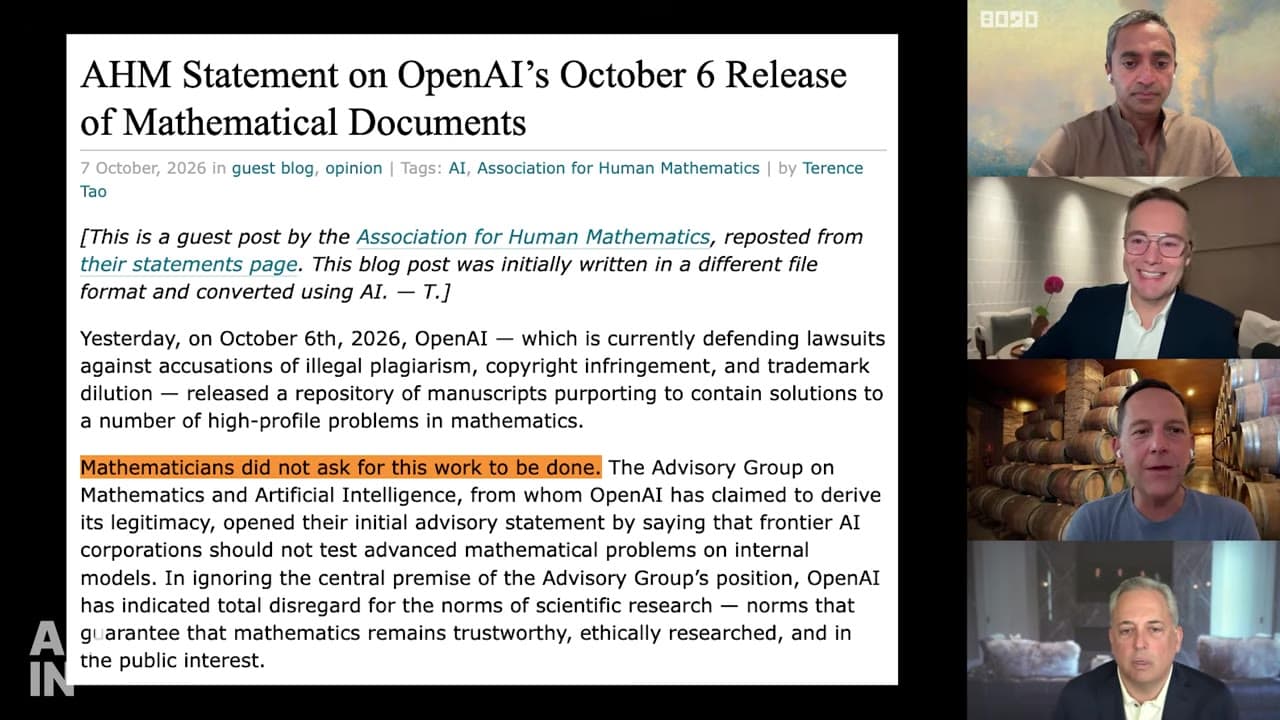
- OpenAI का गणित भंडार: होस्टों के अनुसार 700 से अधिक पेपर; स्क्रीन पर एक शीर्षक ने आँकड़ा 377 गणित समस्याओं पर रखा। Scientific American का हवाला देते हुए होस्टों ने कहा कि Lean से जाँचे नतीजे संभवतः सही हैं, पर अभी सहकर्मी समीक्षा नहीं हुई। कुछ गणितज्ञों ने विरोध किया है।
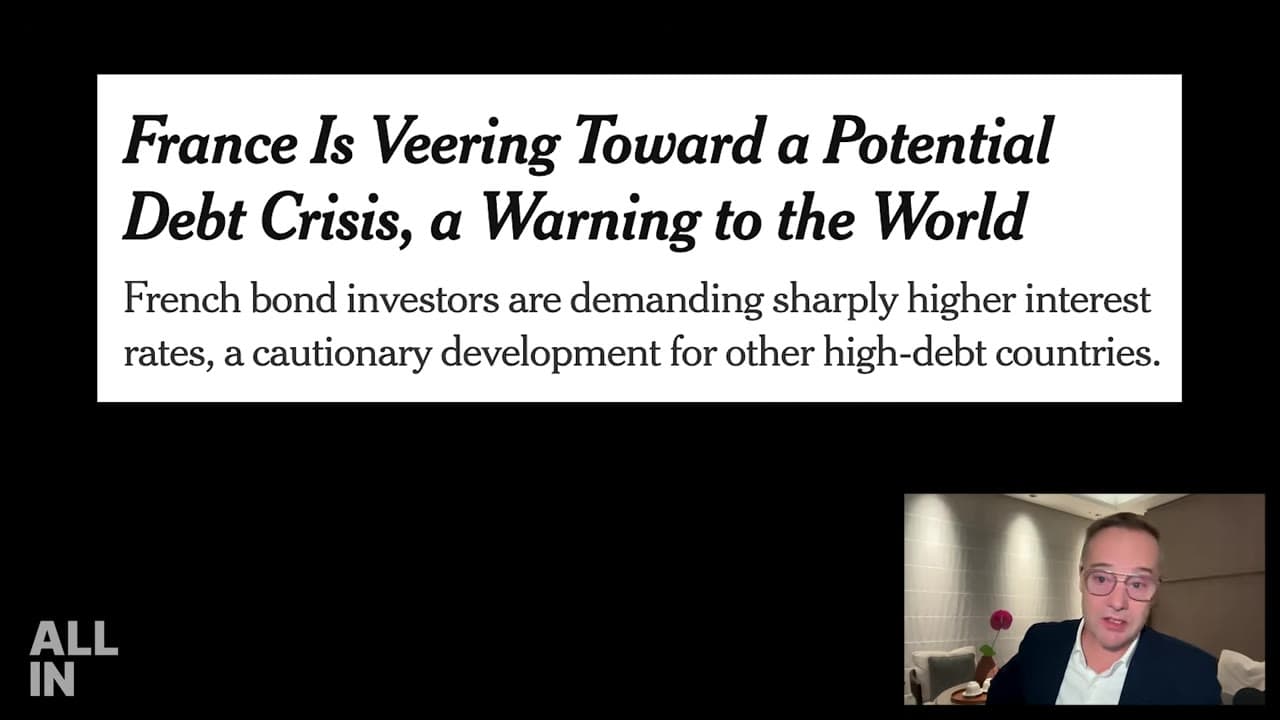
- फ्रांस: दंगे और हड़तालें, कर्ज और मितव्ययिता की आशंकाएँ, और अमेरिकी व ब्रिटिश बॉन्ड यील्ड पर उसका असर।
- सॉफ़्टवेयर आईपी: “हेडलेस” सेवाओं और ओपन-सोर्स क्लोनों ने Palihapitiya को यह कहने पर लाया कि सॉफ़्टवेयर में आईपी अपना मूल्य खो रहा है।