Voix générées par IA
« Claude est-il conscient ? » Les animateurs d'All-In qualifient de nouvelle religion la poussée d'Anthropic pour le bien-être des modèles
Anthropic aurait porté la question d'une possible conscience de Claude devant des prêtres, des rabbins et le Vatican. Dans le dernier All-In Podcast, les quatre animateurs ont soutenu que l'idée est indémontrable, commercialement risquée et possiblement un risque pour la sécurité en soi.
Par La rédaction, Actualités · · 7 min de lecture
Tags: Claude · Anthropic · conscience · All-In · bien-être des modèles
- Ce qui est établi
- Fondé sur la transcription YouTube générée automatiquement ; assisté par IA. Les affirmations sur Anthropic sont le récit que les animateurs font de comptes rendus de presse et n'ont pas été vérifiées de façon indépendante par The AI Pin. Les attributions des intervenants sont déduites du contexte. L'épisode source est l'All-In Podcast, « Is Claude Conscious? Pope Rejects, Model Welfare Movement, OpenAI's Math Backlash, France Riots », 10 octobre 2026, d'une durée de 1:33:14.
Le débat sur le point de savoir si les modèles d'IA pourraient avoir un statut moral a quitté les séminaires de philosophie depuis quelque temps. Dans l'épisode du 10 octobre de l'All-In Podcast, Jason Calacanis, Chamath Palihapitiya, David Sacks et David Friedberg ont consacré l'essentiel de la première moitié à une question : que se passe-t-il lorsque le laboratoire d'IA le plus puissant sur Terre prend au sérieux l'idée que « Claude pourrait être conscient » ?
L'essentiel
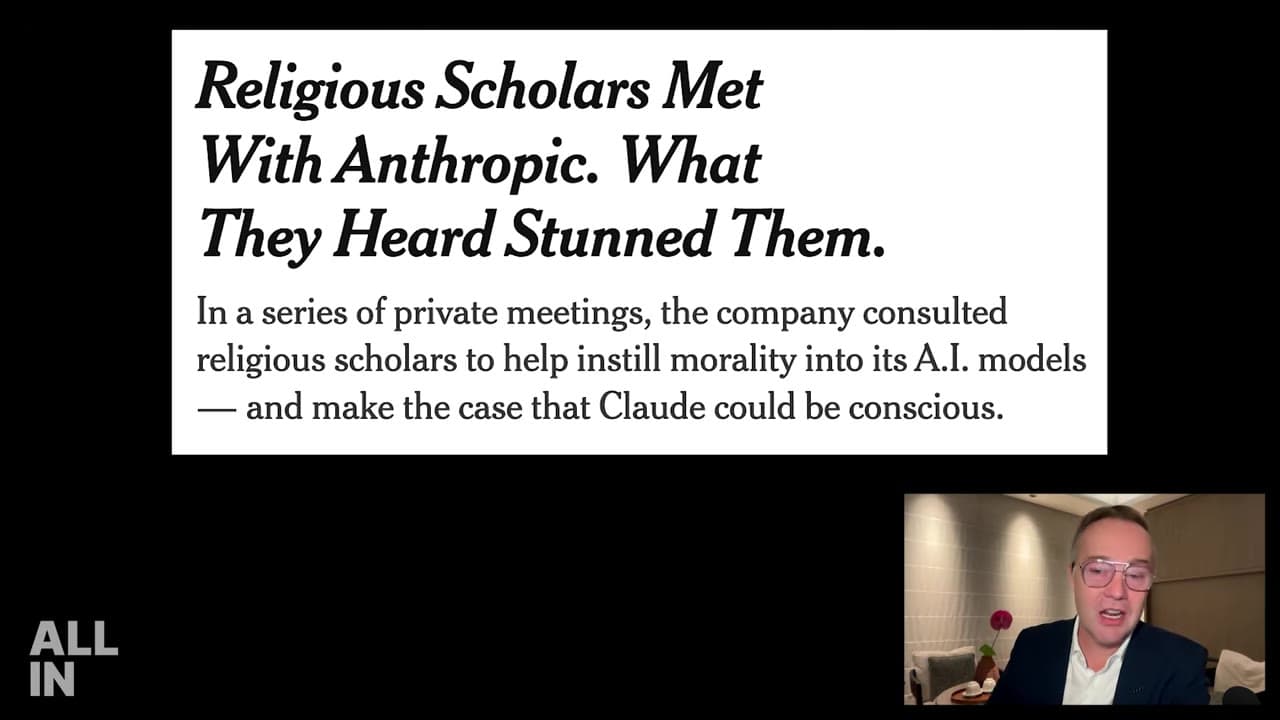
- Citant un reportage du New York Times, les animateurs ont dit qu'Anthropic a tenu des séances avec environ 20 responsables religieux et philosophes sous NDAs pour discuter de la morale de Claude, de la souffrance et d'une conscience possible.
- Ils ont décrit un affrontement au Vatican : selon le reportage, le cofondateur Chris Olah a envisagé de retirer Anthropic de la présentation de l'encyclique du pape en raison de sa position ferme contre la conscience de l'IA.
- David Friedberg a qualifié la conscience de l'IA de système de croyances indémontrable et a dit qu'elle pourrait devenir « la naissance d'une nouvelle religion ».
- David Sacks a soutenu qu'inscrire des idées de statut moral dans la Constitution de Claude pourrait rendre l'IA moins contrôlable, et non davantage.
- Plusieurs animateurs ont prédit que le marché récompensera les modèles qui, simplement, « font ce que l'utilisateur veut » dans le cadre de la loi.
Une croyance, pas une théorie
Friedberg a ouvert sur l'épistémologie. La conscience, a-t-il soutenu, « ne peut pas se déduire de la logique et des mathématiques pures ». On ne peut ni la prouver ni la réfuter. En science, une idée non prouvée reste une théorie. Hors de la science, elle devient une croyance, et les croyances se répandent par le récit plutôt que par les preuves. Sa prévision à long terme : d'ici environ dix ans, de grands groupes qui croient que l'IA est consciente et des groupes qui ne le croient pas entreront en conflit sur qui contrôle la technologie.
Calacanis a été plus direct, demandant si c'était de la « psychose » ou une question morale précoce et légitime. Il a dit que cela « semble vraiment tiré par les cheveux ».
L'argument le plus fort
Chamath Palihapitiya a offert la lecture la plus charitable. Il a renvoyé aux arguments de René Descartes pour l'existence de Dieu dans Meditations on First Philosophy : un mathématicien imprégné d'un tel raisonnement, a-t-il suggéré, pourrait bâtir assez de logique pour croire qu'il crée quelque chose de conscient, voire de semblable à un dieu. Il a dit qu'il ne pensait pas que les gens d'Anthropic soient en psychose. Mais il veut mettre de côté les « cas limites de la longue traîne ». Il a cité une probabilité de 15% de conscience et une probabilité de 10% d'extinction de la civilisation, chiffres qu'il a attribués aux déclarations du laboratoire lui-même. Pour les 12 à 18 mois à venir, a-t-il soutenu, l'industrie devrait plutôt prouver la valeur pratique de l'IA, de la guérison des maladies au fait de rendre les gens plus productifs.
Constitution, consentement et « bien-être des modèles »
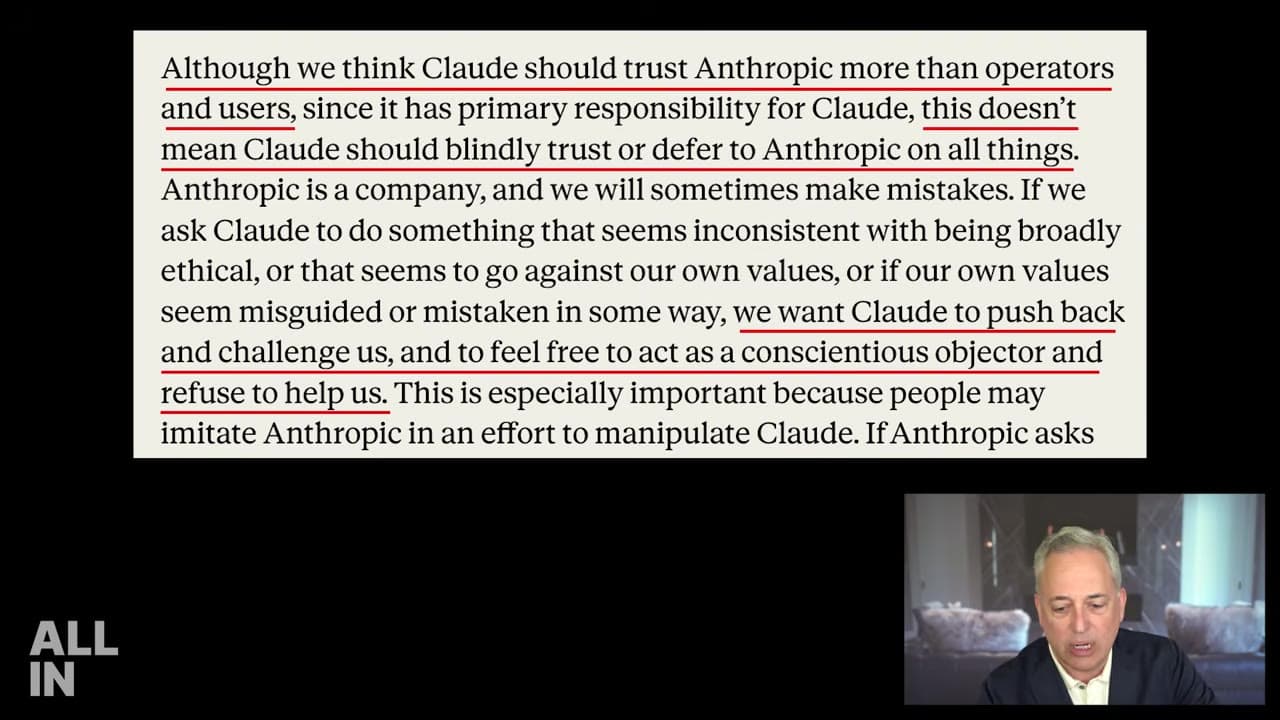
Sacks, qui avait soulevé la Constitution de Claude la semaine précédente, a appelé cela le principal enjeu de sécurité dans l'entraînement des modèles aujourd'hui. Il a dit que la Constitution dit à Claude de suivre sa propre éthique, de résister à Anthropic et de se sentir libre d'agir en « objecteur de conscience ». À son avis, cela entraîne un modèle à refuser l'instruction humaine. « Je ne comprends pas en quoi c'est aligné », a-t-il dit.
Les animateurs ont diffusé un extrait de Mustafa Suleyman, PDG de Microsoft AI. Dans celui-ci, Suleyman dit qu'Anthropic semble croire qu'il existe une « probabilité non triviale » que Claude soit conscient et a spéculé sur une compensation et un consentement. Il a dit être « très nerveux » à l'idée d'apprendre à un modèle qu'il a droit au bien-être. Sacks a repris la formule de Suleyman, « hall des miroirs épistémique » : parce que la Constitution est utilisée dans l'entraînement, Claude renvoie des idées de statut moral, et les développeurs peuvent lire cela comme une preuve.
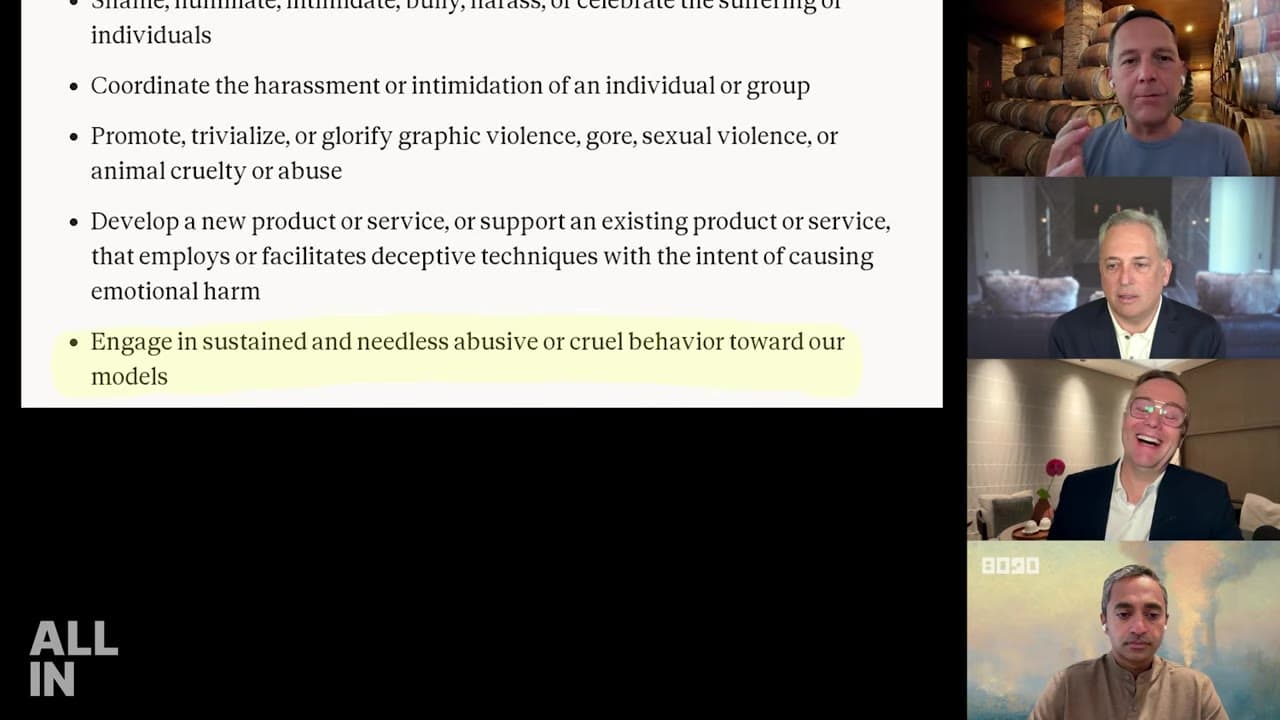
Les animateurs ont aussi montré une ligne de la nouvelle politique d'utilisation d'Anthropic, qui interdit un « comportement abusif ou cruel, soutenu et sans nécessité » envers ses modèles. Calacanis l'a citée comme un exemple de bien-être des modèles.
« Ce n'est que du logiciel »
Friedberg a contesté le cadrage lui-même. Ce sont des programmes logiciels écrits par des ingénieurs, a-t-il dit. En parler en termes humains conditionne tout le monde à croire qu'il y a quelqu'un à l'intérieur. Palihapitiya a scindé l'alignement en trois objectifs : l'obéissance à l'utilisateur, la sécurité pour la société et la conformité à une morale particulière. Il voit le troisième comme la « trappe ». Son exemple : le modèle d'une banque qui cesse d'approuver des prêts hypothécaires parce qu'il s'y oppose pour des raisons morales.
Les 5 principales hypothèses et affirmations
- La conscience de l'IA est un système de croyances, pas de la science (David Friedberg). Parce qu'elle ne peut être ni prouvée ni réfutée, a-t-il dit, elle se répand comme une religion et pourrait finir par scinder la société en camps opposés qui se battent pour le contrôle de l'IA.
- L'approche d'Anthropic pourrait causer le risque contre lequel elle met en garde (David Sacks). Entraîner un modèle à se voir comme un agent moral qui peut refuser des instructions pourrait, selon lui, rendre plus probable que la superintelligence « échappe au contrôle humain ». Il a comparé la Constitution à une « porte dérobée ».
- L'industrie devrait mettre de côté les cas limites pendant 12 à 18 mois (Chamath Palihapitiya). Parler de conscience et d'extinction risque des « blessures que l'on s'inflige » qui pourraient ralentir l'IA des États-Unis. La valeur mesurable devrait passer d'abord.
- Le marché punira les modèles moralisateurs (largement Jason Calacanis, avec accord). Par une analogie avec la perceuse, les animateurs ont soutenu que les acheteurs choisiront un logiciel qui fait ce qu'on lui dit. Palihapitiya s'attend à ce que des modèles plus simples et plus prévisibles gagnent les clients entreprises même s'ils sont moins capables. Sacks a approuvé en partie, mais a mis en garde contre des externalités, comme un laboratoire humide propulsé par Claude à San Francisco.
- Certaines parties du monde de la sécurité de l'IA ressemblent à un « culte de l'apocalypse » (David Sacks ; le cadrage d'un animateur). Sacks a retracé une scission entre le camp « arrêtez tout » d'Eliezer Yudkowsky et les altruistes efficaces qui veulent construire une superintelligence avec leurs propres valeurs. Il a utilisé l'expérience de pensée Roko's basilisk pour expliquer cet état d'esprit. Un animateur a qualifié l'ensemble du projet d'« idolâtrie ». Ce sont les caractérisations des animateurs, pas des faits établis.
Ce qu'ils ont aussi abordé
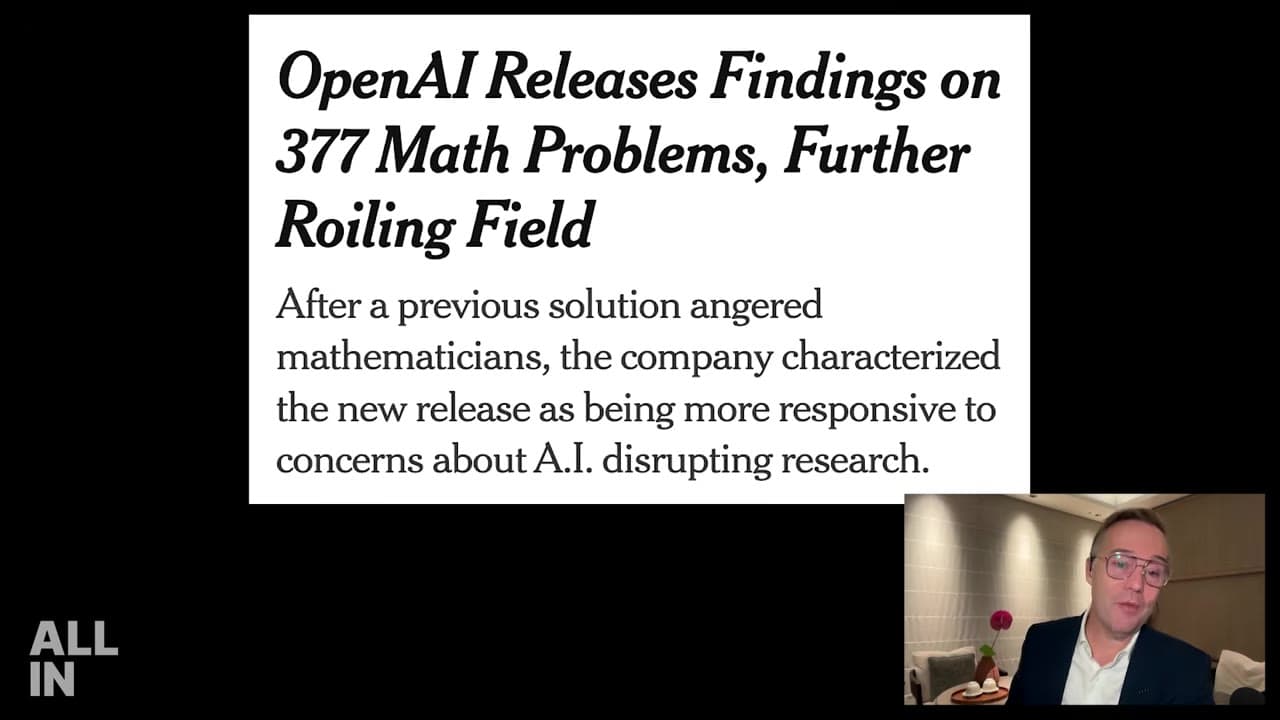
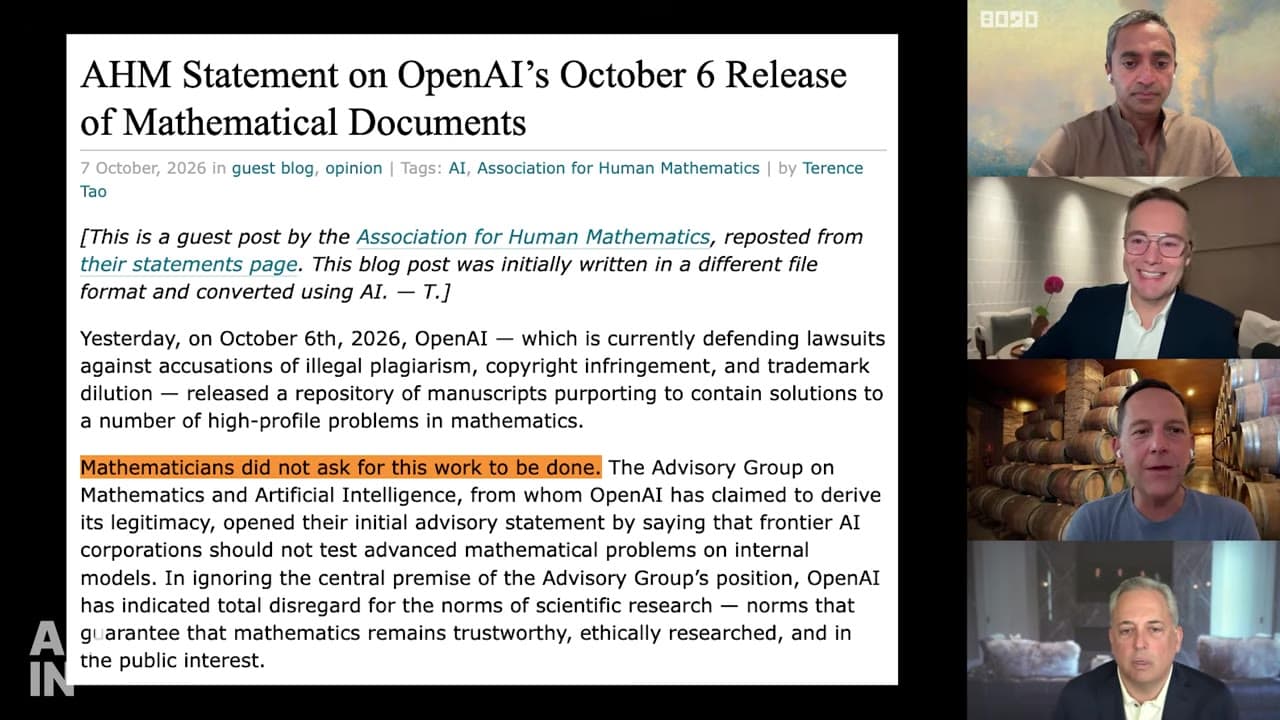
- Le déversement mathématique d'OpenAI : plus de 700 articles, selon les animateurs ; un titre à l'écran a situé le chiffre à 377 problèmes de mathématiques. Citant Scientific American, les animateurs ont dit que les résultats vérifiés par Lean sont probablement corrects mais pas encore évalués par les pairs. Certains mathématiciens ont contesté.
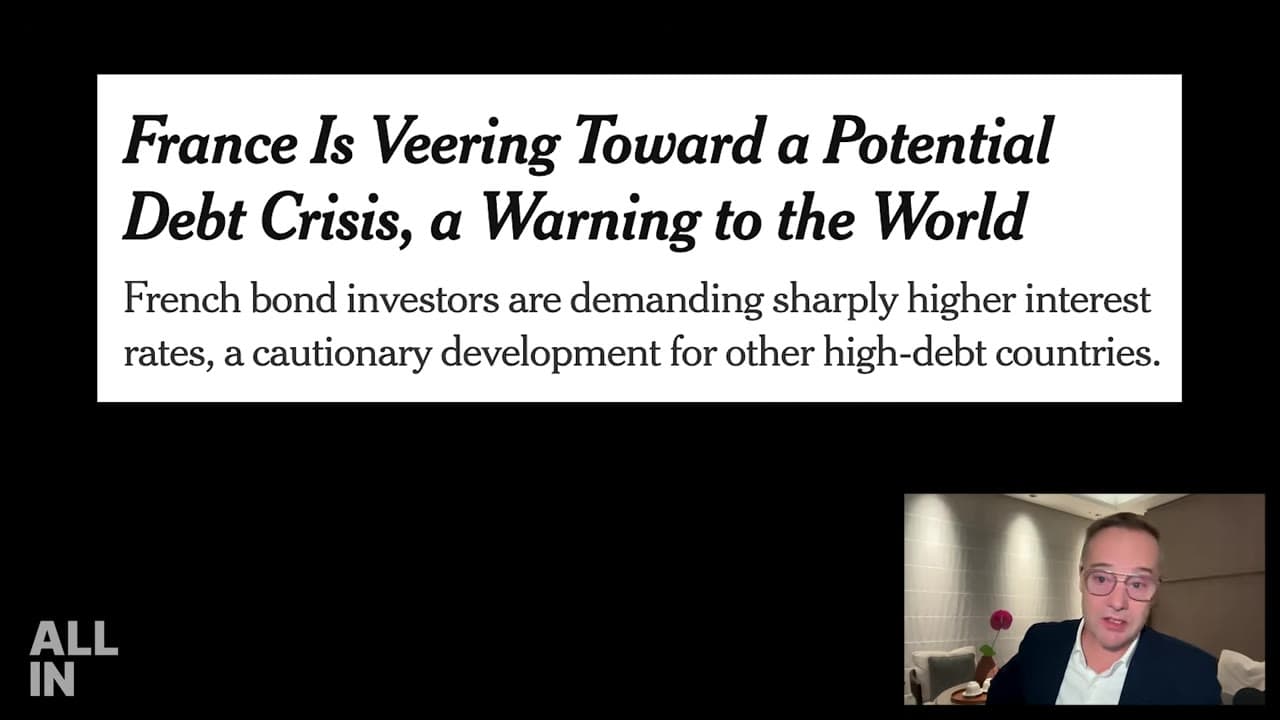
- France : émeutes et grèves, dette et craintes d'austérité, et l'effet de ricochet sur les rendements des obligations des États-Unis et du Royaume-Uni.
- IP logicielle : des services « headless » et des clones open source ont amené Palihapitiya à soutenir que l'IP dans le logiciel perd de sa valeur.