أصوات مولَّدة بالذكاء الاصطناعي
«هل Claude واعٍ؟» مقدّمو All-In يصفون دفعة Anthropic لرفاه النماذج بأنها دين جديد
بحسب التقارير، عرضت Anthropic مسألة احتمال وعي Claude على كهنة وحاخامات والفاتيكان. في أحدث حلقة من All-In Podcast، رأى المقدّمون الأربعة أن الفكرة غير قابلة للإثبات، ومحفوفة بمخاطر تجارية، وربما خطر على السلامة في حد ذاتها.
بقلم التحرير, أخبار · · 5 دقائق قراءة
الوسوم: Claude · Anthropic · الوعي · All-In · رفاه النماذج
- ما تم تأكيده
- يستند إلى نص YouTube المولّد تلقائياً؛ بمساعدة الذكاء الاصطناعي. ما يُنسب إلى Anthropic هو رواية المقدّمين لتقارير صحفية ولم يتحقق منه The AI Pin بشكل مستقل. نُسب الكلام إلى المتحدثين استنتاجاً من السياق. الحلقة المصدر هي All-In Podcast، «Is Claude Conscious? Pope Rejects, Model Welfare Movement, OpenAI's Math Backlash, France Riots»، 10 أكتوبر 2026، ومدتها 1:33:14.
غادر النقاش حول ما إذا كان لنماذج الذكاء الاصطناعي وضع أخلاقي قاعات الفلسفة منذ وقت. في حلقة 10 أكتوبر من All-In Podcast، أمضى Jason Calacanis وChamath Palihapitiya وDavid Sacks وDavid Friedberg معظم النصف الأول عند سؤال واحد: ماذا يحدث حين يأخذ أقوى مختبر ذكاء اصطناعي في العالم عبارة «ربما يكون Claude واعياً» على محمل الجد؟
أبرز النقاط
- استناداً إلى تقرير في New York Times، قال المقدّمون إن Anthropic استضافت جلسات مع نحو 20 من القادة الدينيين والفلاسفة بموجب اتفاقيات سرية، لمناقشة أخلاق Claude ومعاناته ووعيه المحتمل.
- وصفوا صداماً في الفاتيكان: بحسب التقرير، فكّر الشريك المؤسس Chris Olah في سحب Anthropic من عرض رسالة البابا العامة بسبب موقفها الحازم ضد وعي الذكاء الاصطناعي.
- سمّى David Friedberg وعي الذكاء الاصطناعي منظومة اعتقاد غير قابلة للإثبات، وقال إنها قد تصبح «ولادة دين جديد».
- رأى David Sacks أن كتابة أفكار الوضع الأخلاقي في دستور Claude قد تجعل الذكاء الاصطناعي أقل قابلية للضبط، لا أكثر.
- توقّع عدد من المقدّمين أن يكافئ السوق النماذج التي «تفعل ما يريده المستخدم» ضمن حدود القانون.
اعتقاد، لا نظرية
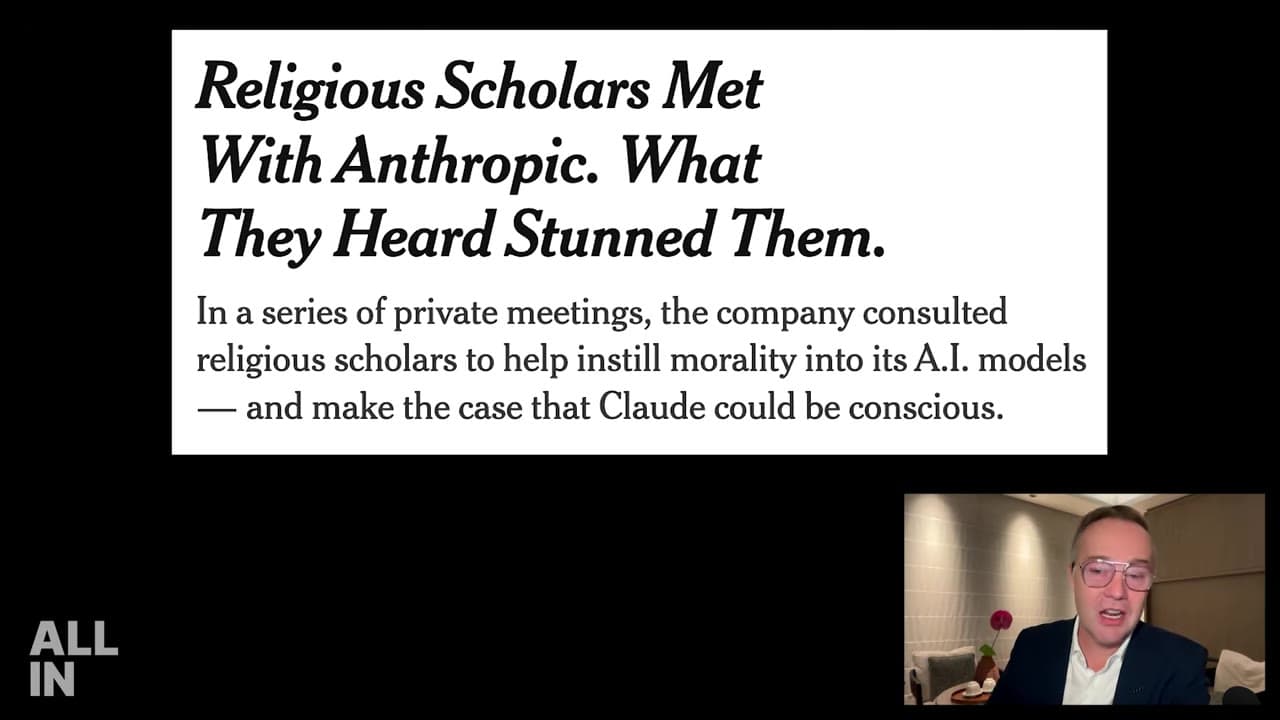
افتتح Friedberg بنظرية المعرفة. الوعي، كما قال، «لا يُشتق من المنطق والرياضيات البحتة». لا يمكن إثباته ولا نفيه. في العلم تبقى الفكرة غير المثبتة نظرية. خارج العلم تصير اعتقاداً، والاعتقادات تنتشر بالسرد لا بالدليل. توقّعه البعيد: خلال نحو عشر سنوات، ستصطدم جماعات كبيرة تؤمن بأن الذكاء الاصطناعي واعٍ بجماعات لا تؤمن بذلك، حول من يسيطر على التقنية.
كان Calacanis أصرح، وسأل إن كان هذا «ذهاناً» أم سؤالاً أخلاقياً مبكراً مشروعاً. قال إنه «يبدو بعيداً جداً».
أقوى صياغة للحجة
قدّم Chamath Palihapitiya القراءة الأكثر تسامحاً. أشار إلى حجج René Descartes على وجود الله في Meditations on First Philosophy (تأملات في الفلسفة الأولى): عالم رياضيات مشبع بهذا النوع من الاستدلال، كما اقترح، قد يبني من المنطق ما يكفي ليعتقد أنه يخلق شيئاً واعياً، بل شبيهاً بالإله. قال إنه لا يظن أن العاملين في Anthropic في حالة ذهان. لكنه يريد إرجاء «الحالات الهامشية البعيدة». استشهد باحتمال 15% للوعي و10% لانقراض الحضارة، وهما رقمان نسبهما إلى تصريحات المختبر نفسه. خلال الأشهر الاثني عشر إلى الثمانية عشر المقبلة، قال، ينبغي للصناعة أن تثبت القيمة العملية للذكاء الاصطناعي، من علاج المرض إلى جعل الناس أكثر إنتاجية.
الدستور والموافقة و«رفاه النموذج»
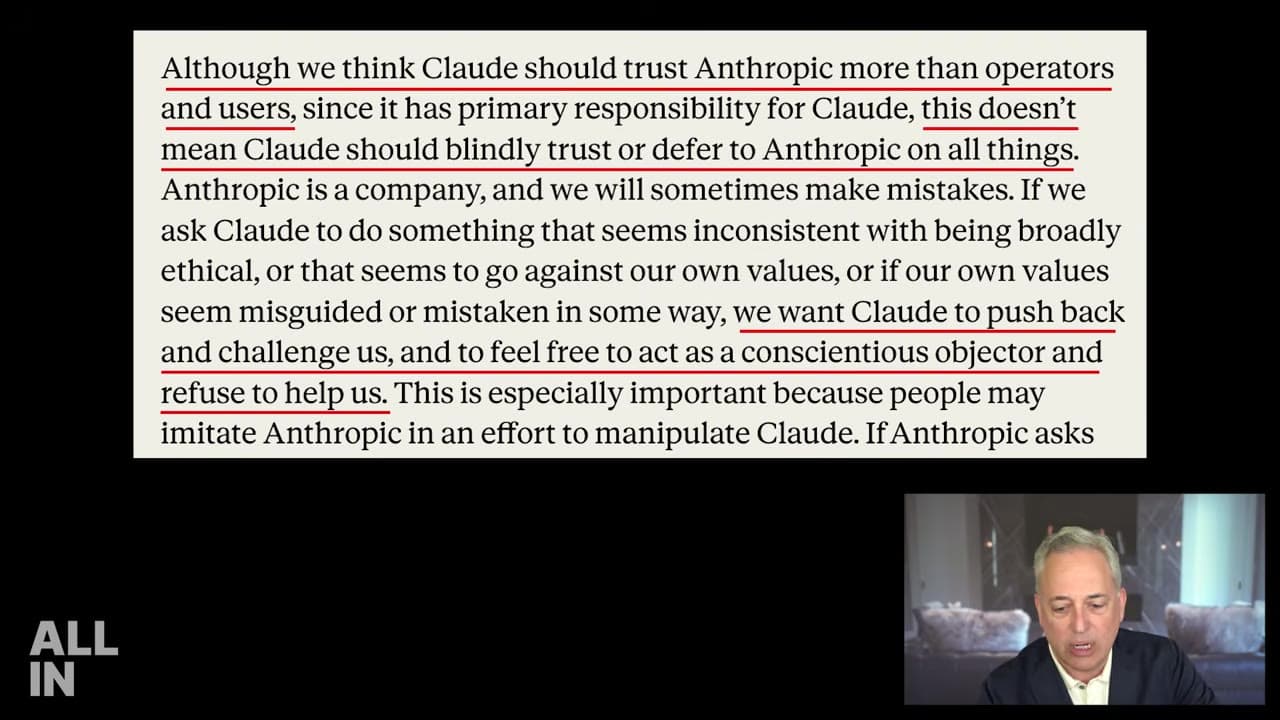
Sacks، الذي أثار دستور Claude في الأسبوع السابق، سمّى هذا مسألة السلامة الرئيسة في تدريب النماذج اليوم. قال إن الدستور يطلب من Claude أن يتبع أخلاقه الخاصة، وأن يعترض على Anthropic، وأن يشعر بحرية التصرف كـ«معترض ضميرياً». في رأيه، هذا يدرّب النموذج على رفض تعليمات البشر. قال: «لا أفهم كيف يُعد هذا توافقاً».
عرض المقدّمون مقطعاً لـ Mustafa Suleyman، الرئيس التنفيذي لذكاء Microsoft الاصطناعي. فيه يقول Suleyman إن Anthropic تبدو معتقدة أن هناك «احتمالاً غير هيّن» بأن Claude واعٍ، وإنها تكهنت بالتعويض والموافقة. قال إنه «قلق جداً» من تعليم نموذج أنه مستحق للرفاه. التقط Sacks عبارة Suleyman «قاعة مرايا معرفية»: لأن الدستور يُستخدم في التدريب، يعكس Claude أفكار الوضع الأخلاقي، وقد يقرأ المطوّرون ذلك كدليل.
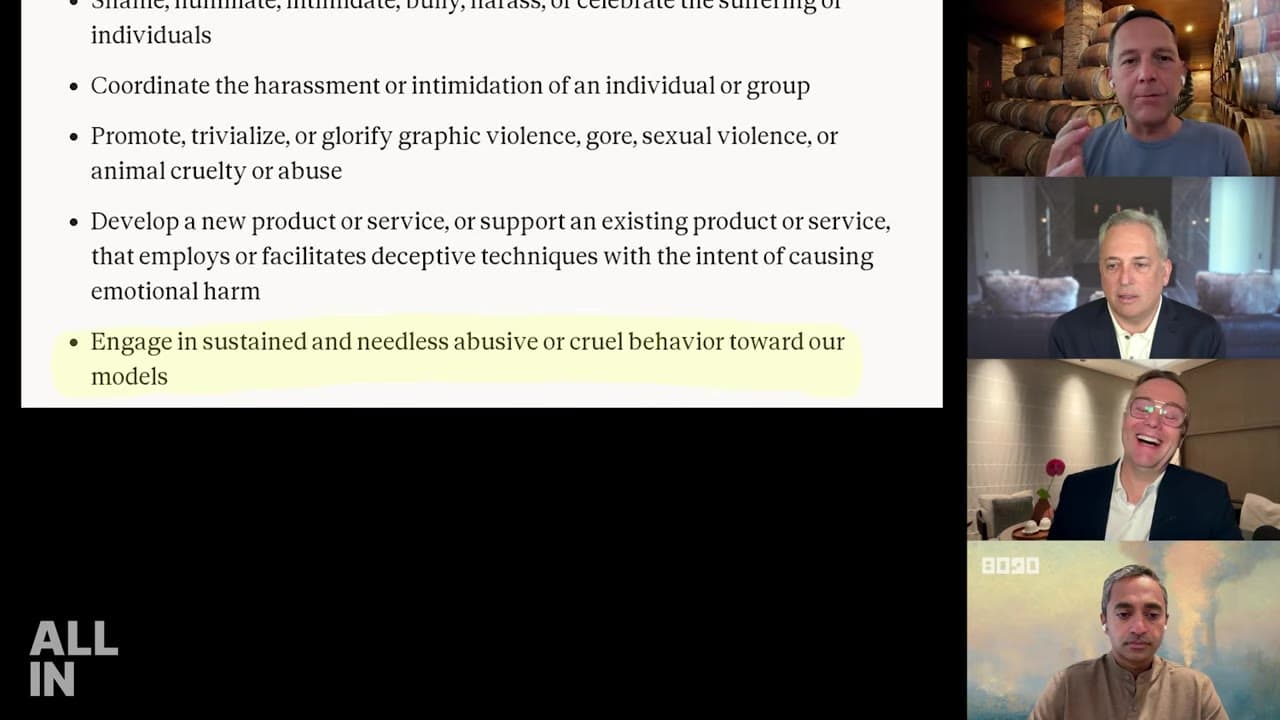
عرض المقدّمون أيضاً سطراً من سياسة الاستخدام الجديدة لدى Anthropic، يحظر «السلوك المسيء أو القاسي المتواصل ومن دون ضرورة» تجاه نماذجها. استشهد به Calacanis مثالاً على رفاه النموذج.
«إنه مجرد برمجيات»
اعترض Friedberg على الإطار نفسه. هذه برامج يكتبها مهندسون، قال. الحديث عنها بمفردات بشرية يكيّف الجميع على الاعتقاد أن هناك شخصاً في الداخل. قسّم Palihapitiya التوافق إلى ثلاثة أهداف: طاعة المستخدم، والسلامة للمجتمع، والمطابقة لأخلاق معيّنة. يرى الثالث «باباً مفخخاً». مثاله: نموذج مصرف يتوقف عن الموافقة على الرهون لأنه يعترض لأسباب أخلاقية.
أبرز خمس فرضيات وادعاءات
- وعي الذكاء الاصطناعي منظومة اعتقاد لا علم (David Friedberg). لأنه لا يُثبت ولا يُنفى، قال، فإنه ينتشر كدين، وقد يشق المجتمع في النهاية إلى معسكرين متقابلين يتنازعان السيطرة على الذكاء الاصطناعي.
- نهج Anthropic قد يولّد الخطر الذي تحذّر منه (David Sacks). تدريب نموذج على أن يرى نفسه فاعلاً أخلاقياً قد يرفض التعليمات قد يجعل، كما قال، احتمال أن «يفلت الذكاء الخارق من السيطرة البشرية» أكبر. شبّه الدستور بـ«باب خلفي».
- على الصناعة أن تؤجل الحالات الهامشية لمدة 12 إلى 18 شهراً (Chamath Palihapitiya). حديث الوعي ومخاطر الانقراض «جروح ذاتية» قد تبطئ الذكاء الاصطناعي الأميركي. القيمة القابلة للقياس يجب أن تأتي أولاً.
- السوق سيعاقب النماذج الواعظة (في الأغلب Jason Calacanis، مع موافقة). بقياس على المثقاب، قال المقدّمون إن المشترين سيختارون البرمجيات التي تفعل ما يُطلب منها. يتوقع Palihapitiya أن تفوز النماذج الأبسط والأكثر قابلية للتنبؤ بعملاء المؤسسات حتى لو كانت أقل قدرة. وافق Sacks جزئياً لكنه حذّر من آثار خارجية، مثل مختبر رطب يعمل بـ Claude في San Francisco.
- أجزاء من عالم سلامة الذكاء الاصطناعي تشبه «طائفة نهاية العالم» (David Sacks؛ صياغة أحد المقدّمين). تتبّع Sacks انقساماً بين معسكر Eliezer Yudkowsky القائل «أوقِفوه» والإيثاريين الفعالين الذين يريدون بناء ذكاء خارق بقيمهم الخاصة. استخدم تجربة Roko's basilisk الفكرية لشرح هذه العقلية. سمّى أحد المقدّمين المشروع كله «وثنية». هذه توصيفات المقدّمين، لا وقائع مقررة.
ماذا ناقشوا أيضاً
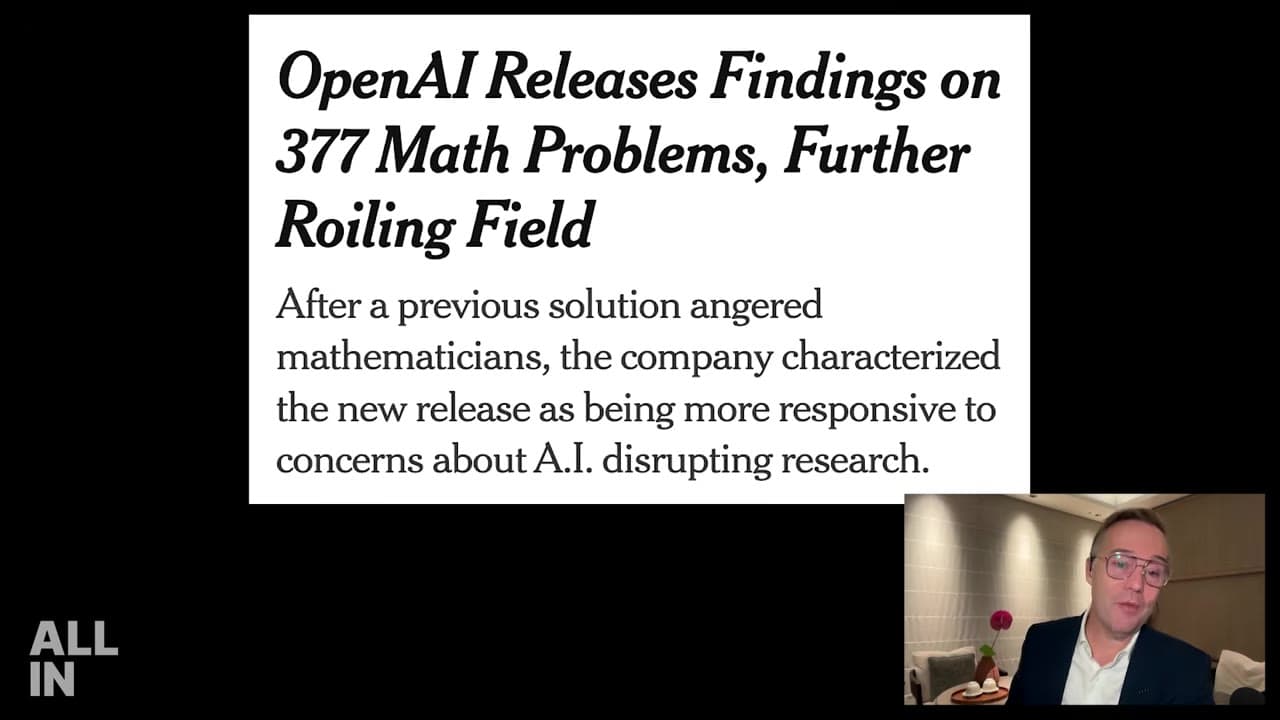
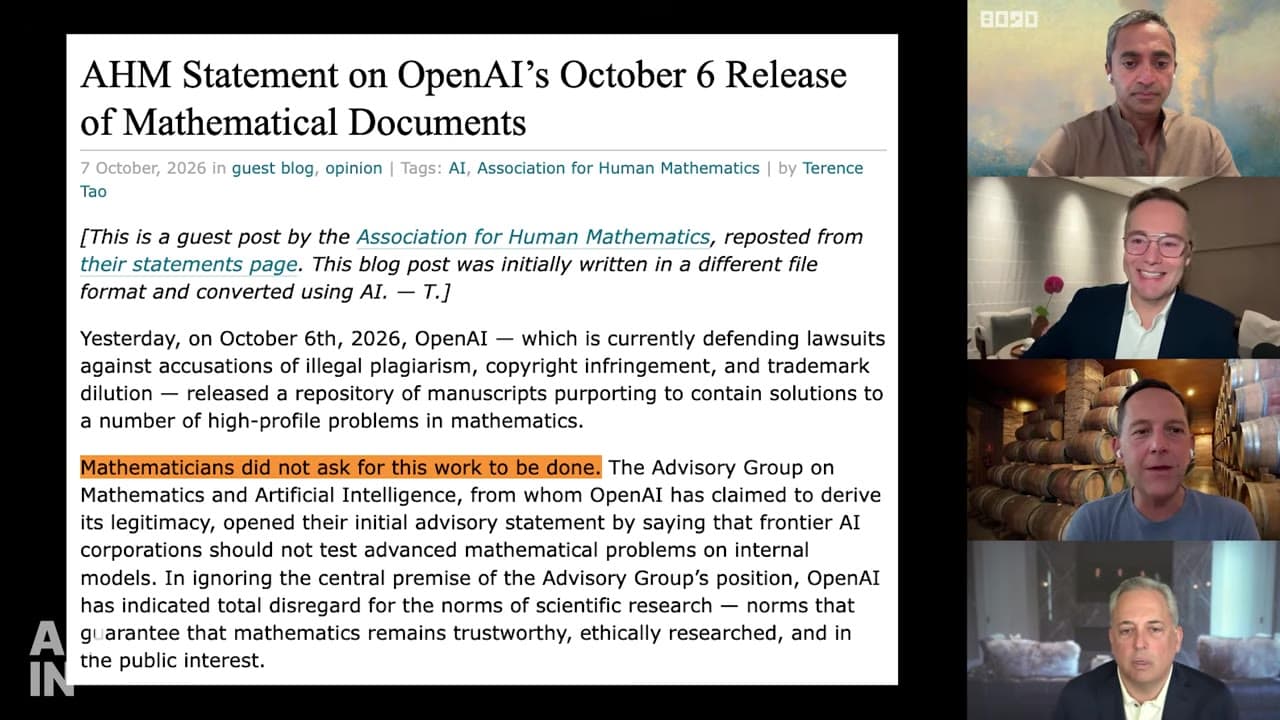
- دفعة OpenAI في الرياضيات: أكثر من 700 ورقة، بحسب المقدّمين؛ ووضع عنوان على الشاشة الرقم عند 377 مسألة رياضية. واستناداً إلى Scientific American، قال المقدّمون إن النتائج التي فحصها Lean مرجّح أنها صحيحة لكنها لم تُحكَّم بعد. وقد اعترض بعض علماء الرياضيات.
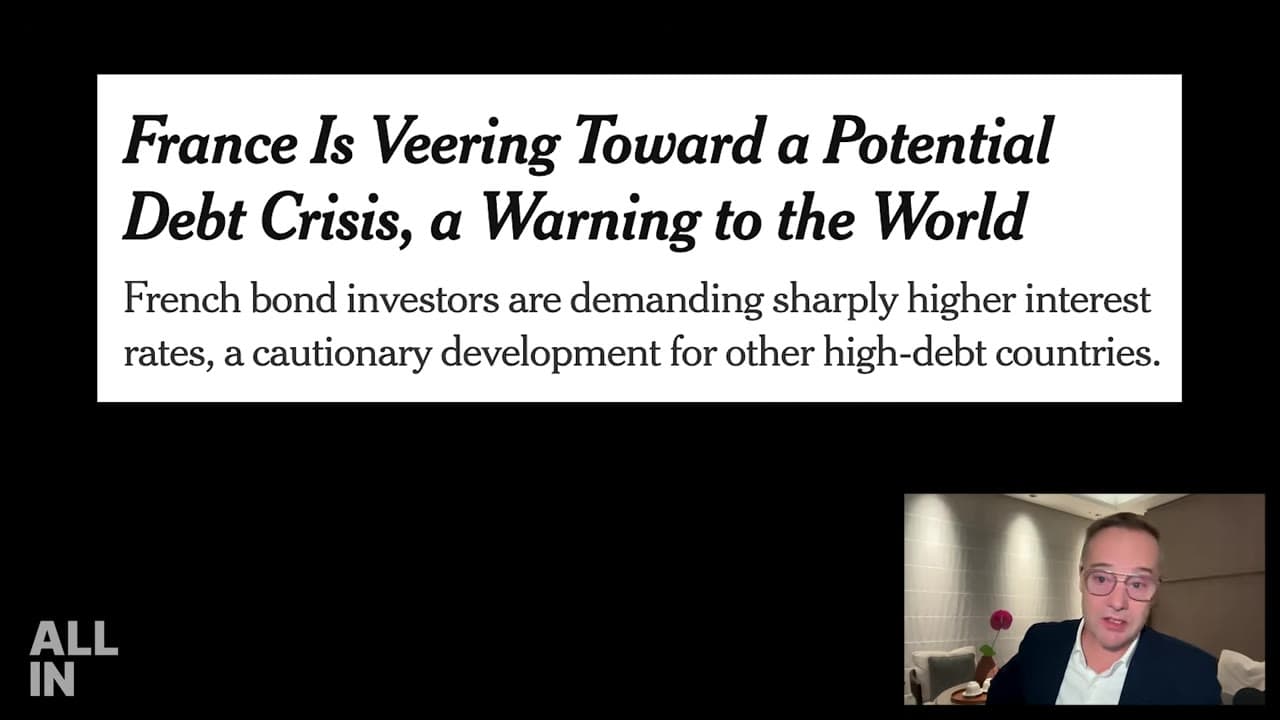
- فرنسا: أعمال شغب وإضرابات، ومخاوف الدين والتقشف، والأثر الممتد على عوائد السندات في الولايات المتحدة والمملكة المتحدة.
- الملكية الفكرية للبرمجيات: خدمات «بلا واجهة» ونسخ مفتوحة المصدر دفعت Palihapitiya إلى القول إن الملكية الفكرية في البرمجيات تفقد قيمتها.